STAC, COG e Zarr: como buscar imagens de satélite na nuvem sem baixar terabytes

Nos meus primeiros projetos com Sentinel-2, o acesso às imagens era manual. No portal do Copernicus (na época, o Open Access Hub), eu escolhia as cenas pela miniatura e baixava um .zip de quase um gigabyte por cena. Depois descompactava, navegava pela pasta .SAFE até GRANULE/.../IMG_DATA e pegava os arquivos .jp2 das bandas de que precisava, em geral duas ou três de um pacote com mais de uma dúzia. Muitas vezes, só nesse ponto eu via que a área de interesse estava coberta de nuvem. Boa parte do tempo ia para baixar e organizar arquivos, e o disco guardava muito mais dado do que a análise usava.
Uma cena Sentinel-2 cobre cerca de 110 × 110 km, e eu quase sempre preciso de um recorte de poucos quilômetros. Numa série temporal, com dezenas de datas e várias bandas, o volume baixado passa de dezenas de gigabytes para analisar uma cidade.
Os dados ficam na nuvem e o código lê só o pedaço de que precisa. Neste artigo, mostro esse caminho na prática, com Recife em 2025 como exemplo. Buscamos as cenas num catálogo STAC, medimos quantos bytes realmente saem de um COG quando pedimos só a área da cidade, montamos um cubo de NDVI mensal sem baixar nenhuma cena inteira e guardamos o resultado em Zarr e COG. O tema é um dos capítulos novos do ebook 2.0. Aqui ele ganha números reais.
Vale reforçar que aqui não estamos falando do Google Earth Engine. Ele também processa na nuvem, mas com catálogo e API próprios, e o código fica preso à plataforma. O foco aqui são os padrões abertos (STAC, COG e Zarr). As plataformas que vamos usar, o Planetary Computer, da Microsoft, e o Earth Search, que indexa os dados abertos hospedados na AWS, são serviços de empresas, gratuitos para buscar e ler, mas não são abertos. Abertos são os dados do Sentinel-2 e o padrão, e é o padrão que permite trocar de provedor, inclusive para catálogos públicos como o Copernicus Data Space, da ESA, e o Brazil Data Cube, do INPE.
Três peças que se encaixam
Antes do código, vale separar as peças, porque cada uma resolve um problema diferente.
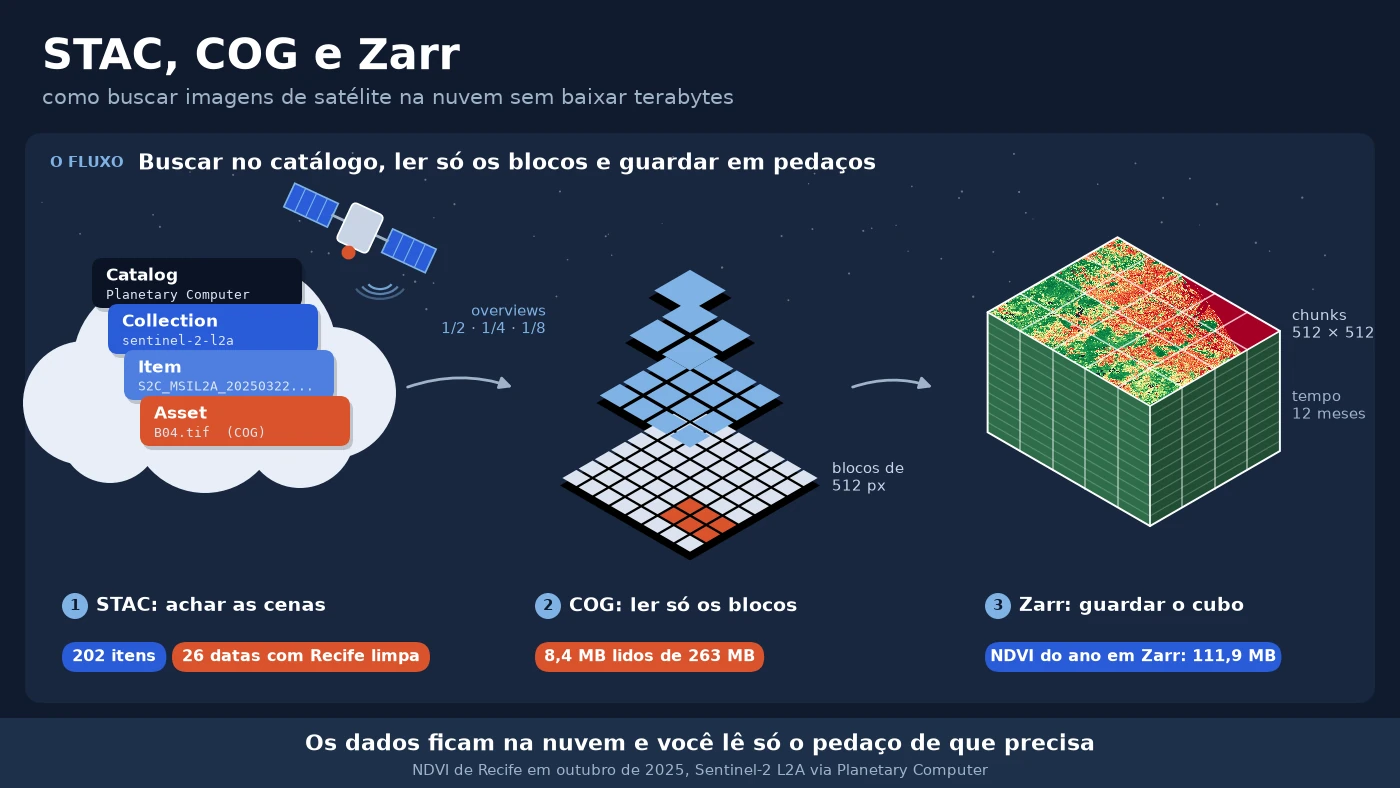
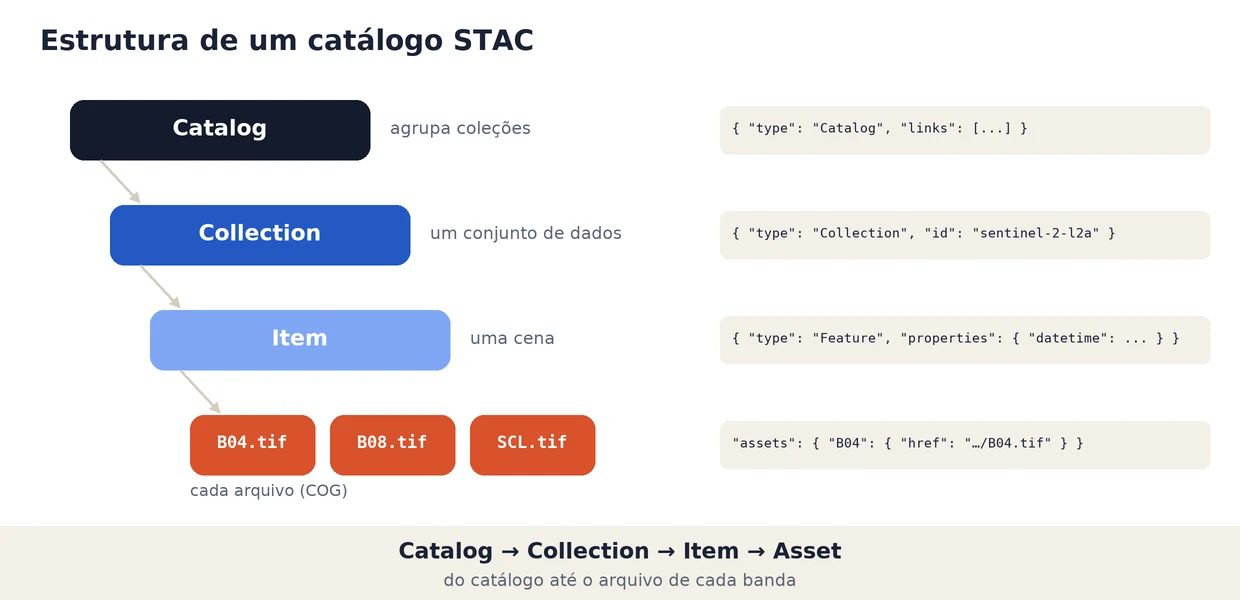
O STAC (SpatioTemporal Asset Catalog) é a especificação aberta que padroniza como descrever e buscar dados geoespaciais em JSON. Ela tem quatro níveis. O Catalog é o ponto de entrada, a Collection agrupa um conjunto de dados (por exemplo, todo o Sentinel-2 nível 2A), o Item descreve uma cena com geometria, data e propriedades, e os Assets são os arquivos do item, um por banda.
O COG (Cloud Optimized GeoTIFF) é um GeoTIFF comum, organizado em blocos (tiles) e com versões reduzidas da imagem (overviews) embutidas. Como o índice dos blocos fica no começo do arquivo, um programa consegue pedir pela internet só os bytes da área e da resolução de que precisa, usando requisições HTTP com cabeçalho Range. Qualquer software que lê GeoTIFF também lê um COG.
O Zarr guarda arrays multidimensionais (tempo × linha × coluna, por exemplo) em pedaços independentes, os chunks, cada um num arquivo ou objeto separado. É o formato natural para cubos de dados e séries longas, em que o COG, pensado para uma imagem 2D por arquivo, começa a ficar desajeitado.
Na prática, o STAC responde “onde estão as imagens que eu quero”, o COG responde “como ler só um pedaço de cada imagem” e o Zarr responde “como guardar o cubo que eu montei para ler pedaços dele depois”.
Buscando as cenas de Recife no catálogo
Começamos pelo catálogo STAC do Microsoft Planetary Computer, que é gratuito e não exige conta para buscar. A busca recebe a coleção, um retângulo em longitude e latitude (bounding box) e o período. Repare que nenhum pixel é baixado aqui; o que volta é só metadado.
import pystac_client

BBOX = [-35.02, -8.15, -34.86, -7.95]  # Recife (lon/lat)

catalogo = pystac_client.Client.open("https://planetarycomputer.microsoft.com/api/stac/v1")

todas = catalogo.search(
    collections=["sentinel-2-l2a"],
    bbox=BBOX,
    datetime="2025-01-01/2025-12-31",
).item_collection()

limpas = catalogo.search(
    collections=["sentinel-2-l2a"],
    bbox=BBOX,
    datetime="2025-01-01/2025-12-31",
    query={"eo:cloud_cover": {"lt": 20}},
).item_collection()

print(len(todas), "cenas em 2025 sobre Recife")
print(len(limpas), "cenas com menos de 20% de nuvens")

item = limpas[0]
print("\nprimeiro item:", item.id)
print("nuvens (%):", item.properties["eo:cloud_cover"])
print("tile MGRS:", item.properties["s2:mgrs_tile"])
print("EPSG:", item.properties["proj:code"])
print("assets:", ", ".join(item.assets))
print("\nB04 ->", item.assets["B04"].media_type)
202 cenas em 2025 sobre Recife
7 cenas com menos de 20% de nuvens

primeiro item: S2C_MSIL2A_20250322T124311_R009_T25LBL_20250322T165113
nuvens (%): 6.142854
tile MGRS: 25LBL
EPSG: EPSG:32725
assets: AOT, B01, B02, B03, B04, B05, B06, B07, B08, B09, B11, B12, B8A, SCL, WVP, visual, safe-manifest, granule-metadata, inspire-metadata, product-metadata, datastrip-metadata, tilejson, rendered_preview

B04 -> image/tiff; application=geotiff; profile=cloud-optimized
As duas buscas levaram cerca de sete segundos. As 202 cenas são 100 datas de passagem, porque Recife fica bem na divisa de duas quadrículas de referência do Sentinel-2 (25LBL e 25MBM), e cada passagem gera um item por quadrícula. O tipo do asset B04 já avisa que o arquivo é um COG (profile=cloud-optimized). E o endereço dele tem a mesma estrutura de pastas que eu navegava no .zip (.SAFE/GRANULE/.../IMG_DATA/R10m/), só que termina em .tif, e não em .jp2. O Planetary Computer converteu as bandas originais em JPEG 2000 para COG, e é essa conversão que permite ler só um pedaço de cada uma pela rede.
Com o filtro clássico de menos de 20% de nuvens sobram 7 itens em 5 datas. O ano inteiro de Recife cabe em março, abril e novembro.
O eo:cloud_cover não fala da sua área
O campo eo:cloud_cover é calculado para a quadrícula inteira, cerca de 12 mil km², boa parte deles oceano no caso de Recife. Uma cena pode ter 60% de nuvens no total e estar limpa justamente sobre a cidade, ou o contrário.
Para saber o que acontece na área que importa, usamos a camada SCL (Scene Classification Layer), que acompanha o Sentinel-2 L2A e classifica cada pixel em vegetação, solo, água, nuvem, sombra e outras classes. Para a triagem ser rápida, lemos a SCL em baixa resolução. Com 200 m em vez dos 20 m nativos, o leitor usa as overviews dos COGs e traz poucos bytes por cena.
import odc.stac
import planetary_computer

itens = [planetary_computer.sign(i) for i in todas]  # assina os links dos assets

scl = odc.stac.load(itens, bands=["SCL"], bbox=BBOX, resolution=200,
                    groupby="solar_day", chunks={}).SCL.compute()

com_dado = scl > 0                   # 0 = sem dado
limpo = scl.isin([4, 5, 6])          # vegetação, solo exposto, água
frac = limpo.sum(dim=["x", "y"]) / com_dado.sum(dim=["x", "y"])
print(f"SCL de {scl.sizes['time']} datas a 200 m ({scl.sizes['x']} x {scl.sizes['y']} px)")
print(f"datas com >= 50% de Recife limpa: {int((frac >= 0.5).sum())} de {frac.size}")
SCL de 100 datas a 200 m (90 x 112 px)
datas com >= 50% de Recife limpa: 26 de 100
A triagem das 100 datas levou 11 segundos. O planetary_computer.sign acrescenta aos links um token de acesso temporário, exigido pelo armazenamento do Planetary Computer. O groupby="solar_day" junta as duas quadrículas da mesma passagem numa única data.
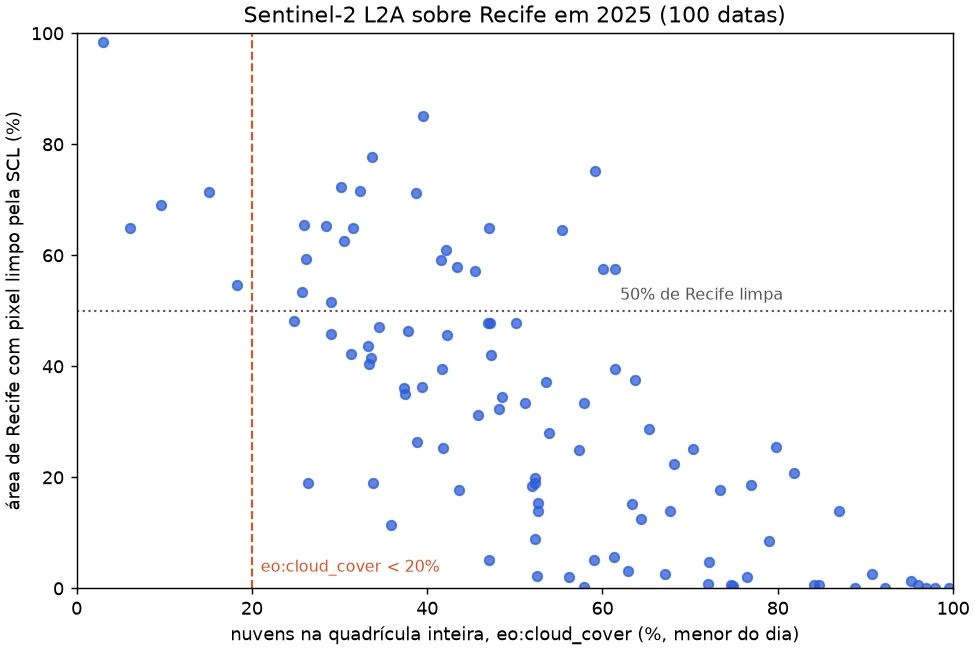
Cada ponto é uma data. No eixo horizontal está o eo:cloud_cover (o menor entre as duas quadrículas do dia) e no vertical, a fração de Recife com pixel limpo segundo a SCL. A correlação existe (0,74), mas a dispersão é grande. Há datas com 40% a 70% de nuvem na cena que deixam mais de 60% da cidade limpa. Com o critério na área de Recife ficamos com 26 datas; com o filtro da cena, 5. São 21 datas boas que o filtro clássico jogaria fora.
Isso não torna o eo:cloud_cover inútil. Ele continua bom como primeiro corte, por exemplo para descartar cenas com mais de 90% de nuvem antes de qualquer leitura. O que não funciona é usá-lo como critério final numa área pequena e nublada como o litoral do Nordeste. Como a leitura da SCL a 200 m custa segundos, vale fazer a triagem na área de interesse sempre que a série for curta ou o lugar for nublado.
Lendo só os bytes que interessam de um COG
Quando pedimos só a área de Recife, quanto do arquivo realmente atravessa a rede? Para medir, abri a banda B04 da cena menos nublada da quadrícula 25MBM, que cobre quase toda a cidade, com um leitor HTTP próprio. O GDAL, que está por trás do rasterio, pede trechos do arquivo, e o leitor faz uma requisição Range para cada trecho e soma os bytes recebidos.
class ArquivoHTTP(io.RawIOBase):
    """Arquivo remoto lido por requisições HTTP Range, com contador de bytes."""

    def read(self, n=-1):
        cab = {"Range": f"bytes={self.pos}-{self.pos + n - 1}"}
        dados = self.sessao.get(self.url, headers=cab).content
        self.pos += len(dados)
        self.bytes_lidos += len(dados)
        self.requisicoes += 1
        return dados
    # seek, tell e o HEAD inicial com o tamanho do arquivo estão no repositório


with rasterio.open("b04.tif", opener=opener) as src:   # opener devolve um ArquivoHTTP
    limites = transform_bounds("EPSG:4326", src.crs, *BBOX)
    janela = from_bounds(*limites, transform=src.transform)
    recife = src.read(1, window=janela)
O parâmetro opener do rasterio (a partir da versão 1.4) deixa o GDAL ler por meio de um objeto Python, o que permite contar os bytes. Fiz três leituras, cada uma abrindo o arquivo do zero.
arquivo B04: 262.9 MB, 10980 x 10980 px, uint16
blocos: [512, 512] | overviews: [2, 4, 8, 16] | compressão: deflate
só o cabeçalho: 5 KB em 112 requisições

janela de Recife: 1774 x 2221 px (3.3% da área da cena)
transferido: 8.4 MB (3.2% do arquivo) em 134 requisições

cena inteira em 1/16: 686 x 686 px
transferido: 0.8 MB (0.3% do arquivo) em 118 requisições
O arquivo tem 262,9 MB e está dividido em 484 blocos de 512 × 512 pixels, com quatro níveis de overview. Só para abrir e conhecer a grade, o GDAL leu 5 KB. Para a janela de Recife, que ocupa 3,3% da área da cena, foram transferidos 8,4 MB, ou 3,2% do arquivo. O custo da leitura acompanha a área pedida, não o tamanho do arquivo. Para uma visão geral da cena inteira, em 1/16 da resolução, bastaram 0,8 MB, porque o leitor foi direto na overview em vez de reduzir os 10980 × 10980 pixels.
O leitor em Python faz uma requisição por trecho e por isso é lento (cerca de 40 segundos para a janela). Ele existe só para medir. Pelo leitor HTTP nativo do GDAL, que junta trechos vizinhos e mantém cache, a mesma janela chegou em 6,6 s e a cena reduzida em 1,4 s, na minha conexão doméstica.
Montando o cubo de NDVI sem baixar as cenas
Com as 26 datas selecionadas, montamos o cubo com o odc-stac. Ele recebe os itens STAC, descobre a grade, lê só a janela de Recife de cada COG e entrega um xarray.Dataset com as dimensões tempo, y e x. Com chunks, a leitura fica preguiçosa (lazy). Nada é lido até o .compute(), e o dask processa bloco a bloco sem precisar do cubo inteiro em memória.
cubo = odc.stac.load(
    itens_selecionados,                 # 54 itens das 26 datas
    bands=["B04", "B08", "SCL"],
    bbox=BBOX,
    resolution=10,
    groupby="solar_day",
    chunks={"x": 1024, "y": 1024},      # leitura preguiçosa com dask
)

# SCL: 4 vegetação, 5 solo exposto, 6 água (o resto é nuvem, sombra, sem dado etc.)
validos = cubo.SCL.isin([4, 5, 6]) & (cubo.B04 > 0)
# a partir da baseline 04.00 (jan/2022) o L2A soma 1000 aos números digitais
red = (cubo.B04.where(validos) - 1000) / 10000
nir = (cubo.B08.where(validos) - 1000) / 10000
soma = nir + red
ndvi = ((nir - red) / soma).where(soma > 0)    # água escura pode zerar o denominador

ndvi_mensal = ndvi.resample(time="1MS").median().compute()
O cubo_ndvi.py do repositório também soma o tamanho dos arquivos completos e resume cada mês.
cubo em memória (se carregado inteiro): 1174 MB
arquivos completos de B04, B08 e SCL das 54 cenas: 27.11 GB

NDVI mensal calculado em 219 s
jan: 1 data(s),  50.8% da área com ao menos um pixel limpo, NDVI médio 0.311
fev: 0 data(s),   nan% da área com ao menos um pixel limpo, NDVI médio nan
mar: 2 data(s),  86.6% da área com ao menos um pixel limpo, NDVI médio 0.408
abr: 2 data(s),  99.4% da área com ao menos um pixel limpo, NDVI médio 0.454
mai: 1 data(s),  64.4% da área com ao menos um pixel limpo, NDVI médio 0.406
jun: 2 data(s),  76.5% da área com ao menos um pixel limpo, NDVI médio 0.386
jul: 2 data(s),  83.4% da área com ao menos um pixel limpo, NDVI médio 0.401
ago: 0 data(s),   nan% da área com ao menos um pixel limpo, NDVI médio nan
set: 2 data(s),  81.9% da área com ao menos um pixel limpo, NDVI médio 0.371
out: 5 data(s),  99.2% da área com ao menos um pixel limpo, NDVI médio 0.415
nov: 5 data(s),  98.3% da área com ao menos um pixel limpo, NDVI médio 0.410
dez: 4 data(s),  97.3% da área com ao menos um pixel limpo, NDVI médio 0.397
Dois detalhes desse trecho merecem atenção. O primeiro é o deslocamento radiométrico. Desde janeiro de 2022 (processing baseline 04.00), os números digitais do Sentinel-2 L2A vêm somados de 1000, e o Planetary Computer não corrige isso. O script confere a baseline de cada item antes de subtrair. O segundo é a água escura, em que vermelho e infravermelho podem chegar a zero depois da correção. Na primeira execução, esqueci a proteção do denominador e o NDVI médio de julho saiu como -inf.
A grade final tem 1776 × 2221 pixels de 10 m em 26 datas. Se carregássemos as três bandas inteiras em memória, seriam 1,17 GB. Os arquivos completos dessas mesmas bandas nas 54 cenas somam 27,11 GB, porque cada um cobre a quadrícula toda. Não medi os bytes transferidos no cubo, mas a leitura segue a mesma lógica da seção anterior, só os blocos que cobrem Recife, em vez das cenas inteiras. O cálculo completo levou 219 segundos na minha máquina, a maior parte esperando a rede.
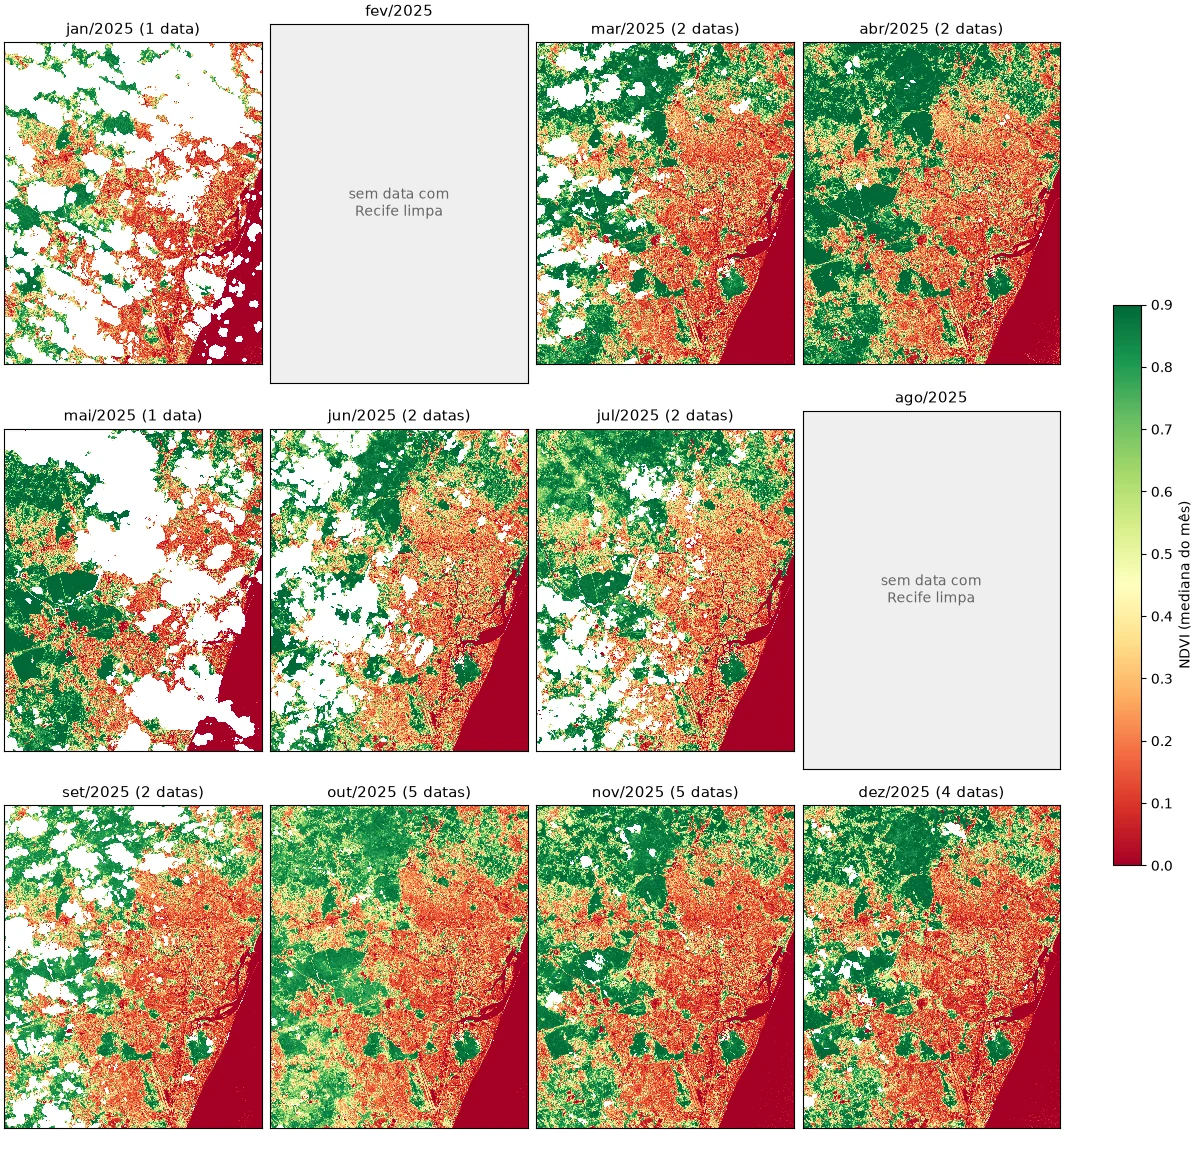
No painel, a mancha urbana aparece em laranja e vermelho, as matas do oeste e do norte em verde-escuro, e o mar e o Capibaribe abaixo de zero. Fevereiro e agosto não têm nenhuma data com pelo menos metade de Recife limpa e ficaram vazios. Janeiro e maio dependem de uma única data e ainda têm grandes buracos de nuvem (em branco). O que a leitura parcial muda é o custo de descobrir isso. A triagem do ano levou segundos e o cubo, alguns minutos, sem baixar nenhuma cena.
Guardando o resultado em Zarr e em COG
O NDVI mensal é o produto que outras análises vão consumir, então vale guardá-lo num formato que preserve a vantagem da leitura parcial. Gravamos o cubo em Zarr, com um chunk por mês e blocos de 512 × 512 pixels.
ds = ndvi_mensal.astype("float32").to_dataset(name="ndvi")
ds.chunk({"time": 1, "y": 512, "x": 512}).to_zarr("saida/ndvi_recife_2025.zarr", mode="w")
Para extrair a série de NDVI de um ponto de mata densa na região de Dois Irmãos, o Zarr só precisa abrir os chunks que contêm aquele pixel, um por mês.
ds = xr.open_zarr("saida/ndvi_recife_2025.zarr")
x, y = Transformer.from_crs("EPSG:4326", "EPSG:32725", always_xy=True).transform(-34.936, -8.024)
serie = ds["ndvi"].sel(x=x, y=y, method="nearest").values
ndvi: (12, 2221, 1776) float32 | chunks de (1, 512, 512)
200 arquivos de chunk, 111.9 MB no disco (sem compressão seriam 180.6 MB)

ponto (-34.936, -8.024): chunks lidos 12 de 240
2025-01 nan
2025-02 nan
2025-03 0.903
2025-04 0.922
2025-05 nan
2025-06 0.911
2025-07 0.932
2025-08 nan
2025-09 0.892
2025-10 0.869
2025-11 0.875
2025-12 0.813
O cubo tem 240 chunks possíveis (12 meses × 5 × 4 blocos), mas só 200 viraram arquivo. Os 40 de fevereiro e agosto, inteiramente vazios, nem foram gravados, porque o Zarr 3 não escreve chunks que só contêm o valor de preenchimento. Com a compressão padrão, os 180,6 MB do array ocupam 111,9 MB. Para a série do ponto, foram lidos 12 dos 240 chunks, 5% do cubo. Se esse Zarr estivesse num bucket na nuvem, seriam 12 requisições pequenas, e não o download do cubo. A série também mostra a nuvem de novo, com quatro meses sem observação nesse pixel de mata, que fica entre 0,81 e 0,93 quando aparece.
Quando o consumidor é um SIG (QGIS, ArcGIS Pro) ou um servidor de mapas, o formato mais prático é o COG. Com GDAL 3.1 ou mais recente, o rioxarray grava direto com o driver COG.
outubro = ds["ndvi"].sel(time="2025-10").squeeze("time", drop=True)
outubro.rio.write_crs("EPSG:32725").rio.to_raster(
    "saida/ndvi_recife_2025_10.tif", driver="COG", compress="DEFLATE", predictor=3, blocksize=512
)
COG de outubro: {'px': [1776, 2221], 'bloco': [512, 512], 'overviews': [2, 4, 8], 'compressao': 'deflate', 'mb': 15.97, 'layout': 'COG'}
O arquivo tem 15,97 MB, blocos de 512 × 512 e três níveis de overview gerados automaticamente. O layout: COG confirma que o GDAL gravou na organização otimizada, com o índice no começo do arquivo.
No dia a dia, uso COG para uma imagem por data, que vai ser aberta num SIG ou servida como mapa, e Zarr para um cubo que será fatiado no tempo e no espaço por código.
O mesmo código em outro catálogo
A promessa do STAC é que o mesmo código funcione em qualquer catálogo. Testei a busca com filtro de nuvens no Earth Search, da Element 84, que indexa a cópia do Sentinel-2 hospedada na AWS.
CATALOGOS = {
    "Planetary Computer": ("https://planetarycomputer.microsoft.com/api/stac/v1", "sentinel-2-l2a"),
    "Earth Search": ("https://earth-search.aws.element84.com/v1", "sentinel-2-c1-l2a"),
}
for nome, (url, colecao) in CATALOGOS.items():
    itens = pystac_client.Client.open(url).search(
        collections=[colecao], bbox=BBOX, datetime="2025-01-01/2025-12-31",
        query={"eo:cloud_cover": {"lt": 20}},
    ).item_collection()
    datas = sorted({i.datetime.date().isoformat() for i in itens})
    print(f"{nome}: {len(itens)} itens, {len(datas)} datas, coleção {colecao}")
    print("  bandas do primeiro item:", ", ".join(sorted(itens[0].assets)[:12]), "...")
Planetary Computer: 7 itens, 5 datas, coleção sentinel-2-l2a
  bandas do primeiro item: AOT, B01, B02, B03, B04, B05, B06, B07, B08, B09, B11, B12 ...
Earth Search: 7 itens, 5 datas, coleção sentinel-2-c1-l2a
  bandas do primeiro item: aot, blue, cloud, coastal, granule_metadata, green, nir, nir08, nir09, preview, product_metadata, red ...
A busca é idêntica e os dois catálogos devolvem as mesmas 5 datas, sem nenhuma que apareça só em um deles. Mas a portabilidade tem limites que aparecem logo no passo seguinte. Os nomes dos assets mudam (red e nir no Earth Search, B04 e B08 no Planetary Computer). E a coleção sentinel-2-c1-l2a declara no próprio asset a escala e o deslocamento (scale: 0.0001, offset: -0.1 em raster:bands), que no Planetary Computer aplicamos à mão. O STAC padroniza a busca e a descrição, não a semântica de cada coleção. Trocar de catálogo é trocar a URL, o nome da coleção, um pequeno dicionário de bandas e conferir a radiometria.
Considerações finais
Saímos de um ano de imagens sobre Recife, 202 itens no catálogo, e chegamos a um NDVI mensal guardado em Zarr e COG sem baixar nenhuma cena inteira. O STAC encontrou as cenas, a SCL lida pelas overviews separou as datas úteis em segundos e o COG entregou só os blocos da cidade. Os arquivos completos das bandas usadas somariam 27,11 GB; o produto final, em Zarr, tem 111,9 MB.
Esse caminho vale a pena quando a área de interesse é bem menor que a cena, quando a série tem muitas datas e quando o processamento pode rodar perto dos dados, numa máquina na mesma região da nuvem. Ele perde força quando você vai processar cenas inteiras repetidas vezes (aí baixar uma vez e trabalhar local sai mais barato) ou quando a conexão é instável, porque cada leitura depende da rede. E os catálogos mudam com reprocessamentos, então, para um estudo reprodutível, guarde a lista de itens usados, como fiz no repositório.
Os dados, os itens STAC da busca e os programas deste artigo estão no repositório do blog no GitHub.
No fim, muda mais o hábito do que a ferramenta. A pergunta deixa de ser “quais arquivos eu preciso baixar” e passa a ser “quais bytes eu preciso ler”.
Referências
- STAC Specification 1.1.0, Radiant Earth Foundation.
- Cloud Optimized GeoTIFF e driver COG do GDAL.
- Zarr, especificação e biblioteca Python.
- Microsoft Planetary Computer e Earth Search.
- odc-stac, carregamento de itens STAC em xarray.