GraphRAG geoespacial em comparação com RAG vetorial

Projetos com RAG raramente falham por falta de dados, os problemas sempre costuma ser outro. Os dados existem, mas o método de recuperação nem sempre sustenta perguntas que dependem de relações entre entidades, principalmente quando essas relações não estão explícitas no texto. Em muitos casos, o sistema recupera trechos semanticamente relevantes, mas não consegue comprovar conexões como proximidade, coocorrência territorial, dependência entre categorias ou encadeamento de evidência. fazendo com que o resultado tenda até ter uma ser uma resposta plausível, porém difícil de auditar.
Neste artigo, sigo a linha dos anteriores e apresento um pipeline pensado para comparar, na prática, um RAG vetorial tradicional e um GraphRAG, neste vou continuar utilizando o mesmo conjunto do OpenStreetMap (OSM), e aplicar sobre ele a discretização territorial com H3 e contruir o nosso grafo com relações espaciais para apoiar perguntas que exigem evidência relacional. Ao invezer de validar somente a qualidade do texto gerado, vamos fazer um experimento e comparar o que cada abordagem recupera, quais vínculos consegue demonstrar e como isso afeta rastreabilidade e verificação.
A primeira estratégia é um baseline vetorial. Nela, cada POI vira um documento curto, e a recuperação ocorre por similaridade semântica via embeddings. Já a segunda estratégia é o GraphRAG. Nesse fluxo, a recuperação inicial ocorre por zonas territoriais, e a evidência é construída ao explicitar relações de proximidade entre categorias, com distância e IDs da região. Em outras palavras, o LLM recebe não apenas itens, mas pares e vínculos entre eles que justificam a resposta.
import os, json, time, math, random
from pathlib import Path

import requests
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

import h3
import re
import networkx as nx
from tqdm import tqdm

import folium
from folium.plugins import MarkerCluster
from pyvis.network import Network

from sklearn.preprocessing import normalize
from sklearn.metrics.pairwise import cosine_similarity

from openai import OpenAI
from google.colab import userdata

os.environ["OPENAI_API_KEY"] = userdata.get("OPENAI_API_KEY")
client = OpenAI()

EMBED_MODEL = "text-embedding-3-small"
LLM_MODEL = "gpt-4o-mini"
Recorte do território e categorias do diagnóstico
O ponto de partida é definir o recorte espacial com um centro em latitude e longitude e um raio em metros para consulta na base do OSM. Aqui, vamos usar um raio de 5 km, suficiente para capturar diversidade de registos e, ao mesmo tempo, permitir inspeção manual dos resultados em mapa.
CENTER_LAT, CENTER_LON = -8.0578, -34.8829
RADIUS_M = 5000
Em seguida, vamos definir as categorias de POIs que possam garantir variação e cobertura para as perguntas para o teste. No conjunto vamos incluir waste_disposal, recycling, fountain, park e water_point. De maneira geral, a escolha não tem como objetivo representar toda a infraestrutura ambiental urbana, e sim formar um conjunto consistente de entidades para testar perguntas relacionais. Além disso, para reduzirmos fragmentação de vocabulário, drinking_water é normalizado como water_point, evitando que a mesma ideia apareça como categorias diferentes.
AMENITIES = ["waste_disposal", "recycling", "fountain", "park", "water_point"]

AMENITY_REMAP = {
    "drinking_water": "water_point",
}
Coleta de dados no OSM com Overpass e cache local
A coleta usa a Overpass API, consultando entidades por filtros de tags dentro da área definida pelo raio de busca.
ROAD_HIGHWAY_REGEX = "^(primary|secondary|tertiary|residential)$"
amenities_regex = "|".join(AMENITIES)

q_pois = f"""
[out:json][timeout:120];
(
  node(around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["amenity"~"^({amenities_regex})$"];
  way (around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["amenity"~"^({amenities_regex})$"];
  node(around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["leisure"="park"];
  way (around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["leisure"="park"];
  node(around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["amenity"="drinking_water"];
  way (around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["amenity"="drinking_water"];
);
out tags center;
"""

q_roads = f"""
[out:json][timeout:120];
way(around:{RADIUS_M},{CENTER_LAT},{CENTER_LON})["highway"~"{ROAD_HIGHWAY_REGEX}"];
out tags geom;
"""

data_pois  = overpass(q_pois,  cache_name=f"pois_env_r{RADIUS_M}_{CENTER_LAT}_{CENTER_LON}", force=True)
data_roads = overpass(q_roads, cache_name=f"roads_r{RADIUS_M}_{CENTER_LAT}_{CENTER_LON}")

print(len(data_pois.get("elements", [])), len(data_roads.get("elements", [])))
Para reduzir dependência de rede e deixar o processo mais fácil de reexecutar, vamos criar um cache local no formato JSON, para evitar repetir chamadas em ajustes iterativos e diminui inconsistências causadas por variações momentâneas da API. Além disso, alguns testes de tentativas com espera progressiva, timeouts, limites de taxa e instabilidade.
def cache_path(name):
    return CACHE_DIR / f"{name}.json"

def overpass(query, cache_name, url=OVERPASS_URL, timeout=180, force=False):
    p = cache_path(cache_name)
    if p.exists() and not force:
        return json.loads(p.read_text(encoding="utf-8"))

    headers = {"User-Agent": "graphrag-ambiental/1.0"}
    last_err = None
    for attempt in range(1, 6):
        try:
            r = requests.post(url, data={"data": query}, headers=headers, timeout=timeout)
            r.raise_for_status()
            data = r.json()
            p.write_text(json.dumps(data), encoding="utf-8")
            return data
        except Exception as e:
            last_err = e
            time.sleep(2 * attempt)
    raise RuntimeError(f"Overpass falhou: {last_err}")
No recorte do exemplo, a coleta retorna 411 POIs e 6.407 vias.
Preparação dos dados e discretização territorial
Com os dados brutos, extraio dois DataFrames, um para POIs e outro para vias, e realizar a normalização das categorias para reduzir ambiguidade, remoção de duplicidades por osm_id, padronização de coordenadas em float e cálculo do identificador H3 por entidade, criando uma camada territorial discreta.
def extract_pois(elements):
    rows = []
    seen = set()
    for el in elements:
        tags    = el.get("tags", {})
        amenity = tags.get("amenity") or ("park" if tags.get("leisure") == "park" else None)
        if not amenity:
            continue
        amenity = AMENITY_REMAP.get(amenity, amenity)
        if amenity not in AMENITIES:
            continue

        if el["type"] == "node":
            lat, lon = el["lat"], el["lon"]
        else:
            c = el.get("center")
            if not c:
                continue
            lat, lon = c["lat"], c["lon"]

        osm_id = int(el["id"])
        if osm_id in seen:
            continue
        seen.add(osm_id)

        rows.append({
            "osm_type": el["type"],
            "osm_id":   osm_id,
            "amenity":  amenity,
            "name":     tags.get("name"),
            "lat":      float(lat),
            "lon":      float(lon),
        })

    df = pd.DataFrame(rows)
    if df.empty:
        return df
    df["h3"] = df.apply(lambda r: point_to_h3(r["lat"], r["lon"]), axis=1)
    return df

def extract_roads(elements):
    rows = []
    for el in elements:
        if el.get("type") != "way":
            continue
        geom = el.get("geometry")
        if not geom or len(geom) < 2:
            continue
        mid = geom[len(geom)//2]
        tags = el.get("tags", {})
        rows.append({
            "way_id":  int(el["id"]),
            "highway": tags.get("highway"),
            "name":    tags.get("name"),
            "mid_lat": float(mid["lat"]),
            "mid_lon": float(mid["lon"]),
            "geom":    geom,
        })
    df = pd.DataFrame(rows).drop_duplicates(subset=["way_id"])
    df["h3"] = df.apply(lambda r: point_to_h3(r["mid_lat"], r["mid_lon"]), axis=1)
    return df
df_pois = extract_pois(data_pois["elements"])
df_roads = extract_roads(data_roads["elements"])
print(df_pois.shape, df_roads.shape)
Dimensões do DataFrame de POIs (411, 7) e Dimensões do DataFrame de Roads (6407, 7)
Realizamos a discretização do h3 usando a resolução 7, sendo esse o passo para não mais tratar o território como um contínuo, passo a operar por zonas. Isso facilita agregação, ranqueamento e recuperação por embeddings, além de reduzir o espaço de busca quando preciso construir evidência relacional.
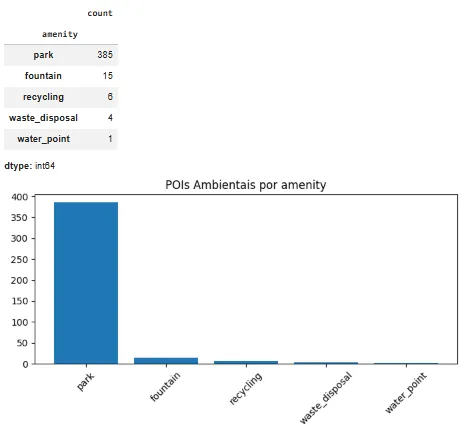
Antes de avançar, vamos dar uma olhada rápida de como está o dataset, realizando a contagens por categoria ajudam a identificar desequilíbrios e a calibrar expectativas.
counts = df_pois["amenity"].value_counts()
display(counts)

plt.figure(figsize=(7, 4))
plt.bar(counts.index, counts.values)
plt.title("POIs Ambientais por amenity")
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()
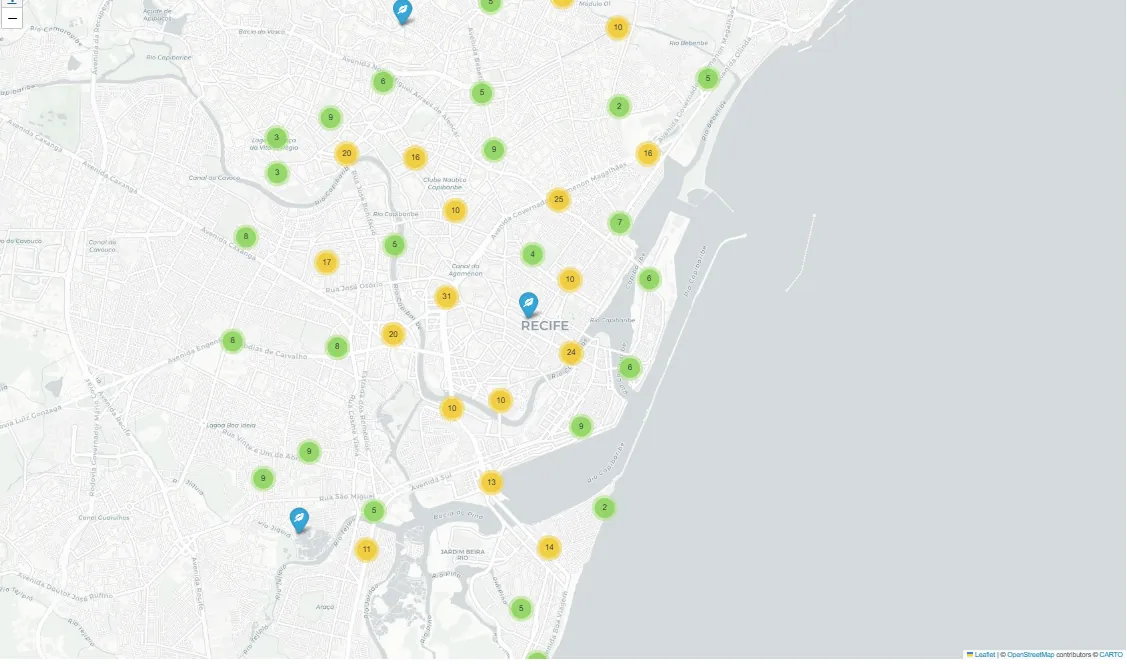
Agora vamos checar e visualizar com o Folium e MarkerCluster e checar a sanidade dos dados.
m = folium.Map(location=[CENTER_LAT, CENTER_LON], zoom_start=14, tiles="cartodbpositron")
cluster = MarkerCluster().add_to(m)

for r in df_pois.itertuples(index=False):
    folium.Marker(
        location=[r.lat, r.lon],
        popup=f"{r.amenity} | {r.name or 'sem nome'}",
        icon=folium.Icon(icon=ICON_MAP.get(r.amenity, "ok-sign"))
    ).add_to(cluster)

display(m)
Grafo base e relações estruturantes
É claro que o grafo é a base do GraphRAG porque materializa relações que um índice vetorial não representa de forma explícita.
G = nx.Graph()
Na modelagem adotada, cada POI vira um nó no padrão poi:, cada célula H3 vira um nó zone:
, cada categoria vira um nó svc: e cada via vira um nó road:.
for r in df_pois.itertuples(index=False):
    pid = f"poi:{r.osm_id}"
    G.add_node(pid, ntype="POI", name=r.name, amenity=r.amenity,
               lat=r.lat, lon=r.lon, h3=r.h3)
    G.add_edge(pid, f"zone:{r.h3}",    etype="IN_ZONE")
    G.add_edge(pid, f"svc:{r.amenity}", etype="IS_A")
Em seguida, o grafo recebe relações estruturantes. A relação IN_ZONE conecta POIs e vias à sua zona H3, enquanto IS_A conecta POIs à categoria de serviço. Mesmo antes das relações de proximidade, essa estrutura já permite perguntas sobre composição por zona e distribuição de categorias.
for r in df_roads.itertuples(index=False):
    rid = f"road:{r.way_id}"
    G.add_node(rid, ntype="ROAD", highway=r.highway, name=r.name,
               lat=r.mid_lat, lon=r.mid_lon, h3=r.h3)
    G.add_edge(rid, f"zone:{r.h3}", etype="IN_ZONE")

print(G.number_of_nodes(), G.number_of_edges())
Tivemos 6839 nodes e 7229 edges
Relações espaciais entre POIs por proximidade
A maior parte das perguntas relacionais depende de proximidade. Por isso, temos que criar arestas NEAR entre POIs quando a distância fica abaixo de um limite, neste caso 500 m, com teto de até 10 vizinhos por POI.
MAX_NEAR_M = 500
MAX_NEAR_PER_POI  = 10
Para reduzir custo, agrupo os POIs por célula H3 e busco candidatos na própria célula e em um anel adjacente usando grid_disk. A distância é calculada com Haversine e as arestas armazenam dist_m, que vira evidência explícita de proximidade.
def haversine_m(lat1, lon1, lat2, lon2):
    R = 6371000.0
    p1, p2 = math.radians(lat1), math.radians(lat2)
    dlat = math.radians(lat2 - lat1)
    dlon = math.radians(lon2 - lon1)
    a = math.sin(dlat/2)**2 + math.cos(p1)*math.cos(p2)*math.sin(dlon/2)**2
    return 2 * R * math.atan2(math.sqrt(a), math.sqrt(1 - a))

bucket = {}
for r in df_pois.itertuples(index=False):
    bucket.setdefault(r.h3, []).append(r)

added = 0
for r in tqdm(df_pois.itertuples(index=False), total=len(df_pois)):
    src = f"poi:{r.osm_id}"
    candidates = []
    for c in [r.h3] + list(h3.grid_disk(r.h3, 1)):
        candidates.extend(bucket.get(c, []))
    scored = []
    for t in candidates:
        if t.osm_id == r.osm_id:
            continue
        d = haversine_m(r.lat, r.lon, t.lat, t.lon)
        if d <= MAX_NEAR_M:
            scored.append((d, t.osm_id))
    scored.sort(key=lambda x: x[0])
    for d, tid in scored[:MAX_NEAR_PER_POI]:
        G.add_edge(src, f"poi:{tid}", etype="NEAR", dist_m=float(d))
        added += 1

print(added, G.number_of_edges())
100%|██████████| 411/411 [00:00<00:00, 2540.21it/s]
3529 8359
Essa parte é o que diferencia o GraphRAG do baseline vetorial, o baseline tende a recuperar itens semanticamente parecidos, mas não garante que estejam próximos no território e não entrega, por padrão, um conjunto de pares que satisfaça a restrição, o que limita a atuação do processo.
def vector_retrieve(query, k=12):
    q_emb = client.embeddings.create(model=EMBED_MODEL, input=query).data[0].embedding
    q_emb = normalize(np.array(q_emb, dtype=np.float32).reshape(1, -1))
    sims  = cosine_similarity(q_emb, poi_emb)[0]
    idx   = np.argsort(-sims)[:k]
    return [(poi_ids[i], poi_docs[i], float(sims[i])) for i in idx]
Conectividade aproximada entre vias
Além de proximidade entre POIs, temos que realizar a criação de CONNECTS entre vias que compartilham pontos amostrados da geometria, basicamente a estratégia quantiza coordenadas para capturar interseções aproximadas e reduzir comparações. Mesmo quando essa relação não entra diretamente no comparativo de respostas, ela agrega valor ao abrir espaço para análises futuras de conectividade e acessibilidade.
ROAD_SAMPLE_STEP = 6

def quantize(lat, lon, ndigits=5):
    return (round(lat, ndigits), round(lon, ndigits))

pt_to_roads = {}
for r in tqdm(df_roads.itertuples(index=False), total=len(df_roads)):
    for p in r.geom[::ROAD_SAMPLE_STEP]:
        key = quantize(p["lat"], p["lon"])
        pt_to_roads.setdefault(key, set()).add(r.way_id)

connects = 0
for key, roads in pt_to_roads.items():
    roads = list(roads)
    if len(roads) < 2:
        continue
    for i in range(min(len(roads), 10)):
        for j in range(i + 1, min(len(roads), 10)):
            G.add_edge(f"road:{roads[i]}", f"road:{roads[j]}", etype="CONNECTS")
            connects += 1

print(connects)
100%|██████████| 6407/6407 [00:00<00:00, 138242.22it/s]
1785
Documentos e embeddings para o baseline vetorial
No baseline vetorial, cada POI é representado como um documento textual curto contendo ID, nome, categoria, coordenadas e zona H3. Além disso, incluir explicitamente o ID, o H3 e as coordenadas ajuda a reduzir ambiguidades quando o LLM precisa justificar a localização.
def poi_doc(row):
    name = row["name"] if pd.notnull(row["name"]) else "sem nome"
    return (
        f"Ativo de Infraestrutura Ambiental ID {row['osm_id']}: {name}. "
        f"Categoria={row['amenity']}. "
        f"Localização (lat={row['lat']:.6f}, lon={row['lon']:.6f}). "
        f"Zona territorial H3={row['h3']}."
    )

poi_docs = df_pois.apply(poi_doc, axis=1).tolist()
poi_ids  = df_pois["osm_id"].tolist()
Em seguida, geramos os embeddings desses documentos utilizando o modelo text-embedding-3-small e realizamos a verificação de similaridade por meio de cosine similarity. Quando a pergunta é recebida, seu embedding é calculado e comparado com o corpus vetorial. Os itens mais similares são então selecionados e utilizados como contexto para a etapa de geração.
EMBED_MODEL = "text-embedding-3-small"
LLM_MODEL = "gpt-4o-mini"

def embed_texts(texts, model=EMBED_MODEL, batch_size=128):
    vecs = []
    for i in tqdm(range(0, len(texts), batch_size)):
        batch = texts[i:i + batch_size]
        resp = client.embeddings.create(model=model, input=batch)
        vecs.extend([d.embedding for d in resp.data])
    return np.array(vecs, dtype=np.float32)

poi_emb = embed_texts(poi_docs)
print(poi_emb.shape)
100%|██████████| 4/4 [00:01<00:00, 2.08it/s](411, 1536)
Esse fluxo é simples e eficiente. Ele funciona bem quando a pergunta é descritiva ou de listagem. A limitação aparece quando a consulta exige relação verificável, como proximidade entre categorias. Nesse caso, a similaridade semântica pode recuperar itens corretos em tema, mas geograficamente dispersos, sem formar pares que satisfaçam a restrição. O modelo passa então a inferir conexão a partir de texto, e não a partir de evidência estrutural.
def vector_retrieve(query, k=12):
    q_emb = client.embeddings.create(model=EMBED_MODEL, input=query).data[0].embedding
    q_emb = normalize(np.array(q_emb, dtype=np.float32).reshape(1, -1))
    sims  = cosine_similarity(q_emb, poi_emb)[0]
    idx   = np.argsort(-sims)[:k]
    return [(poi_ids[i], poi_docs[i], float(sims[i])) for i in idx]

def baseline_answer(query, k=12):
    top = vector_retrieve(query, k=k)
    ctx = "\n".join([f"- {pid} | score={s:.3f} | {doc}" for pid, doc, s in top])
    prompt = (
        "Você é um assistente GeoAI especializado em diagnóstico de infraestrutura ambiental urbana para apoio a decisões públicas e estratégias ESG. Responda SOMENTE com os POIs fornecidos.\n"
        "Se pedir 'perto', use h3/lat/lon como aproximação e explique.\n"
        "Responda em bullets estruturados.\n"
        "Cite sempre os IDs dos ativos ambientais.\n"
        "Inclua interpretação territorial quando possível.\n"
        f"PERGUNTA:\n{query}\n\nCONTEXTO:\n{ctx}"
    )
    return llm_text(prompt), top
Zonas como documentos no GraphRAG e sumários
Já no GraphRAG, a recuperação não começa pelas entidades individuais, mas pelas zonas territoriais. Cada célula H3 é transformada em um documento que sintetiza o perfil da área, incluindo total de ativos e categorias predominantes. Para as zonas mais densas, é gerado um breve sumário executivo com o LLM, com foco em caracterizar o padrão territorial de forma clara e estruturada.
Essa etapa de sumário tem dois objetivos principais. Primeiro, melhorar a qualidade da recuperação por embeddings, já que textos que descrevem o perfil da zona tendem a representar melhor seu contexto do que simples contagens. Segundo, deixar explícito que se trata de uma leitura baseada em dados abertos, evitando que o sumário seja interpretado como diagnóstico oficial ou exaustivo.
zone_stats = (
    df_pois.groupby(["h3", "amenity"])
    .size()
    .reset_index(name="n")
    .sort_values(["h3", "n"], ascending=[True, False])
)
zone_total = df_pois.groupby("h3").size().reset_index(name="total")

zone_card = {}
for h, grp in zone_stats.groupby("h3"):
    top_svc = ", ".join([f"{r.amenity}:{int(r.n)}" for r in grp.head(8).itertuples(index=False)])
    total   = int(zone_total.loc[zone_total["h3"] == h, "total"].iloc[0])
    zone_card[h] = (
        f"Zona territorial H3={h} (resolução={H3_RES}). "
        f"Total de ativos ambientais mapeados={total}. "
        f"Principais categorias de infraestrutura ambiental={top_svc}."
    )

dense_zones = zone_total.sort_values("total", ascending=False)["h3"].head(60).tolist()

def summarize_zone(h):
    prompt = (
        f"Gere um sumário executivo curto (2-4 frases) para apoio a decisão pública "
        f"sobre a infraestrutura ambiental desta zona territorial.\n"
        f"Baseie-se APENAS nos dados:\n{zone_card[h]}\n"
        f"Inclua:\n"
        f"(1) Perfil da infraestrutura ambiental local,\n"
        f"(2) Possível vocação territorial (ex.: lazer, gestão de resíduos, suporte hídrico),\n"
        f"(3) Indique que se trata de uma estimativa baseada em dados abertos."
    )
    return llm_text(prompt)

zone_summary = {}
for h in tqdm(dense_zones):
    zone_summary[h] = summarize_zone(h)

def zone_text(h):
    return zone_summary.get(h, zone_card.get(h, f"Zona H3={h}"))
zone_list = list(zone_card.keys())
zone_docs = [zone_text(h) for h in zone_list]
zone_emb  = normalize(embed_texts(zone_docs))
print(len(zone_list), zone_emb.shape)
100%|██████████| 1/1 [00:00<00:00,  2.88it/s]
15 (15, 1536)
Entendimento da pergunta e extração controlada
Em perguntas relacionais, um erro comum não é o LLM não responder. O erro é o processo não traduzir a pergunta em restrições recuperáveis. Para reduzir esse risco, vamos precisar usar um schema JSON para extrair serviços e pares de serviços que devem estar próximos, raio em metros, dica de lugar e quantidade de zonas na recuperação inicial.
QUERY_SCHEMA = {
    "type": "object",
    "additionalProperties": False,
    "properties": {
        "services": {
            "type": "array",
            "items": {"type": "string", "enum": AMENITIES},
        },
        "near_pairs": {
            "type": "array",
            "items": {
                "type": "object",
                "additionalProperties": False,
                "properties": {
                    "a":        {"type": "string", "enum": AMENITIES},
                    "b":        {"type": "string", "enum": AMENITIES},
                    "radius_m": {"type": "integer", "minimum": 50, "maximum": 5000},
                },
                "required": ["a", "b", "radius_m"],
            },
        },
        "place_hint":  {"type": "string"},
        "top_k_zones": {"type": "integer", "minimum": 1, "maximum": 25},
    },
    "required": ["services", "near_pairs", "place_hint", "top_k_zones"],
}
E vamos precisar criar uma função de parsing para impor um limite e valores padrões, evitando raios irreais e garantindo que perguntas vagas não quebrem o fluxo, e aplicar um fallback, para casos que a pergunta envolva menos de dois serviços e não vier nenhum par de proximidade, crio um par padrão com raio, preservando a natureza relacional do problema.
def parse_query(query):
    prompt = (
        "Extraia estrutura da pergunta no JSON abaixo.\n"
        "Não invente serviços fora do enum.\n\n"
        "REGRAS OBRIGATÓRIAS:\n"
        "- radius_m deve ser entre 50 e 5000. Se não especificado, use 500.\n"
        "- top_k_zones deve ser entre 1 e 25. Se não especificado, use 8.\n"
        "- Se a pergunta mencionar PROXIMIDADE, INTEGRAÇÃO, SINERGIA ou 'perto' "
        "entre dois tipos de serviço, SEMPRE preencha near_pairs com o par correspondente.\n"
        "  Exemplos de mapeamento:\n"
        "    'áreas verdes' ou 'parques' ou 'lazer'-'park'\n"
        "    'reciclagem'                           -'recycling'\n"
        "    'ativos hídricos' ou 'água' ou 'fonte'-'water_point' ou 'fountain'\n"
        "    'descarte' ou 'lixo' ou 'resíduos'    -'waste_disposal'\n"
        "- Se houver dois serviços identificados em contexto de proximidade, "
        "gere um near_pair com esses dois serviços.\n\n"
        f"Schema: {json.dumps(QUERY_SCHEMA)}\n"
        f"Pergunta: {query}\n"
        "Responda SOMENTE com JSON válido, sem markdown."
    )
    raw = llm_text(prompt)
    raw = raw.replace("```json", "").replace("```", "").strip()
    q = json.loads(raw)

    q["top_k_zones"] = max(1, min(25, int(q.get("top_k_zones") or 8)))
    for p in q.get("near_pairs", []):
        p["radius_m"] = max(50, min(5000, int(p.get("radius_m") or 500)))

    # Fallback: se services tem ≥2 itens e near_pairs ainda vazio
    svcs = q.get("services", [])
    if not q.get("near_pairs") and len(svcs) >= 2:
        q["near_pairs"] = [{"a": svcs[0], "b": svcs[1], "radius_m": 500}]

    return q
Como o GraphRAG constrói evidência?
O GraphRAG opera em duas camadas. Na primeira, ele recupera as zonas mais relevantes a partir de embeddings de zona. Em vez de buscar diretamente POIs individuais, rela ranqueia células H3 que tenham um perfil mais compatível com a pergunta, reduzindo o espaço de busca e evitando varrer o território inteiro.
def retrieve_zones(query, topk=10):
    q_emb = client.embeddings.create(model=EMBED_MODEL, input=query).data[0].embedding
    q_emb = normalize(np.array(q_emb, dtype=np.float32).reshape(1, -1))
    sims  = cosine_similarity(q_emb, zone_emb)[0]
    idx   = np.argsort(-sims)[:topk]
    return [(zone_list[i], zone_docs[i], float(sims[i])) for i in idx]
Na segunda camada, eu contruí evidência relacional dentro desse recorte. Ela filtra os POIs contidos nas zonas recuperadas e aplico restrições por categoria de serviço. Quando a pergunta envolve proximidade entre categorias, amplia gradualmente o anel de busca em H3 até obter cobertura suficiente, ou até atingir um limite. Com o conjunto candidato definido, eu calculo pares próximos entre as categorias solicitadas dentro do raio informado e registo a distância em metros, o que vira evidência explícita para sustentar a resposta.
def build_evidence(services, near_pairs, zones_ranked, max_evidence=40, max_ring=2):
    slices = [df_pois[df_pois["h3"].isin(list(h3.grid_disk(h, ZONE_RING)))]
              for h, _, _ in zones_ranked]
    slices = [s for s in slices if not s.empty]
    if not slices:
        return pd.DataFrame(), []
    cand = pd.concat(slices, ignore_index=True).drop_duplicates(subset=["osm_id"])

    if services:
        cand = cand[cand["amenity"].isin(services)]

    evid = []
    if near_pairs:
        # Tenta rings crescentes até achar POIs de ambos os tipos
        ring_df = pd.DataFrame()
        for ring in range(0, max_ring + 1):
            ring_slices = [df_pois[df_pois["h3"].isin(list(h3.grid_disk(h, ring)))]
                           for h, _, _ in zones_ranked]
            ring_slices = [s for s in ring_slices if not s.empty]
            if not ring_slices:
                continue
            candidate = pd.concat(ring_slices, ignore_index=True).drop_duplicates(subset=["osm_id"])

            needed = {p["a"] for p in near_pairs} | {p["b"] for p in near_pairs}
            found  = set(candidate["amenity"].unique())
            if needed.issubset(found):
                ring_df = candidate
                break  # ring suficiente encontrado

        if ring_df.empty:
            # Usa tudo disponível no dataset nas zonas
            ring_df = pd.concat([
                df_pois[df_pois["h3"].isin(list(h3.grid_disk(h, max_ring)))]
                for h, _, _ in zones_ranked
            ], ignore_index=True).drop_duplicates(subset=["osm_id"])

        by_am    = {a: ring_df[ring_df["amenity"] == a].copy() for a in AMENITIES}
        keep_ids = set()

        for p in near_pairs:
            A = by_am.get(p["a"]); B = by_am.get(p["b"])
            if A is None or B is None or len(A) == 0 or len(B) == 0:
                print(f"  near_pair {p['a']}↔{p['b']}: "
                      f"{len(A) if A is not None else 0} tipo-A, "
                      f"{len(B) if B is not None else 0} tipo-B (sem pares possíveis)")
                continue
            B_pts = list(B[["osm_id", "lat", "lon"]].itertuples(index=False))
            for ra in A[["osm_id", "lat", "lon", "name"]].itertuples(index=False):
                dists = [(haversine_m(ra.lat, ra.lon, rb.lat, rb.lon), rb.osm_id)
                         for rb in B_pts
                         if haversine_m(ra.lat, ra.lon, rb.lat, rb.lon) <= p["radius_m"]]
                dists.sort()
                if dists:
                    keep_ids.add(int(ra.osm_id))
                    for d, bid in dists[:5]:
                        keep_ids.add(int(bid))
                        evid.append((int(ra.osm_id), int(bid), float(d),
                                     f"NEAR({p['a']},{p['b']})"))

        cand = ring_df[ring_df["osm_id"].isin(list(keep_ids))].copy()

    return cand.head(max_evidence), evid
Por fim, eu monto o contexto que vai para o LLM em três blocos. O primeiro resume as zonas recuperadas e seus escores. O segundo lista os POIs filtrados com ID, categoria, coordenadas e H3. O terceiro descreve as relações encontradas, incluindo os pares e suas distâncias. Na prática, isso desloca o trabalho do modelo de inventar conexões para explicar conexões já verificadas, enquanto o baseline vetorial tende a recuperar itens semanticamente próximos e deixa a construção do vínculo por conta da geração.
def graphrag_answer(query):
    q            = parse_query(query)
    zones_ranked = retrieve_zones(query, topk=int(q["top_k_zones"]))
    df_ev, edges = build_evidence(q["services"], q["near_pairs"], zones_ranked)

    zone_ctx = "\n".join([f"- Zona {h} | score={s:.3f} | {zone_card[h]}"
                          for h, _, s in zones_ranked[:8]])
    poi_ctx  = "\n".join([
        f"- POI {r.osm_id}: {r.amenity} | {r.name or 'sem nome'} | "
        f"lat={r.lat:.6f}, lon={r.lon:.6f} | h3={r.h3}"
        for r in df_ev.itertuples(index=False)
    ]) if not df_ev.empty else "Nenhum POI encontrado nas zonas recuperadas."
    edge_ctx = "\n".join([f"- POI {a} -> POI {b} | {rel} | dist_m={d:.1f}"
                          for a, b, d, rel in edges[:80]])

    prompt = (
        "Você é um assistente GeoAI especializado em diagnóstico de infraestrutura ambiental urbana. "
        "Responda SOMENTE com base no contexto abaixo.\n"
        "As respostas devem apoiar decisão pública ou análise ESG.\n"
        "Não faça inferências além dos dados listados.\n"
        "Se não houver evidência suficiente, indique claramente a limitação.\n\n"
        f"PERGUNTA:\n{query}\n\n"
        f"ZONAS:\n{zone_ctx}\n\n"
        f"POIs:\n{poi_ctx}\n\n"
        f"RELAÇÕES:\n{edge_ctx}"
    )
    return llm_text(prompt), q, zones_ranked, df_ev, edges
Visualização dos resultados no mapa
Para comparar as duas abordagens de forma que possamos ver os resultados, vamos incluir uma etapa de visualização. A ideia é simples. Plotar os POIs recuperados e, quando houver evidência relacional, desenhar as ligações entre pares próximos. Isso facilita inspeção manual e ajuda a identificar rapidamente limitações do processo de recuperação.
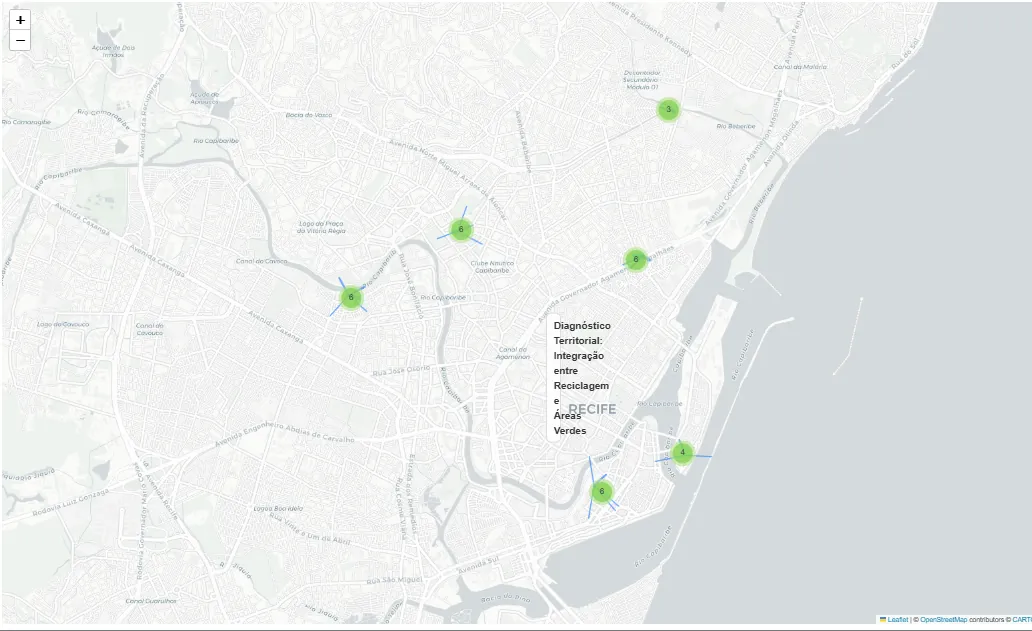
No baseline vetorial, a visualização mostra apenas os POIs retornados pela busca por similaridade. Como não há relações explícitas nesse fluxo, o mapa serve principalmente para verificar dispersão territorial.
def show_baseline_on_map(top_base, title="Baseline Recuperado"):
    ids = [pid for pid, _, _ in top_base]
    df_base = df_pois[df_pois["osm_id"].isin(ids)].copy()

    m = folium.Map(location=[CENTER_LAT, CENTER_LON], zoom_start=14, tiles="cartodbpositron")

    for r in df_base.itertuples(index=False):
        folium.Marker(
            location=[r.lat, r.lon],
            popup=f"{r.amenity} | {r.name or 'sem nome'} | POI {r.osm_id}",
            icon=folium.Icon(icon=ICON_MAP.get(r.amenity, "ok-sign"))
        ).add_to(m)

    return m
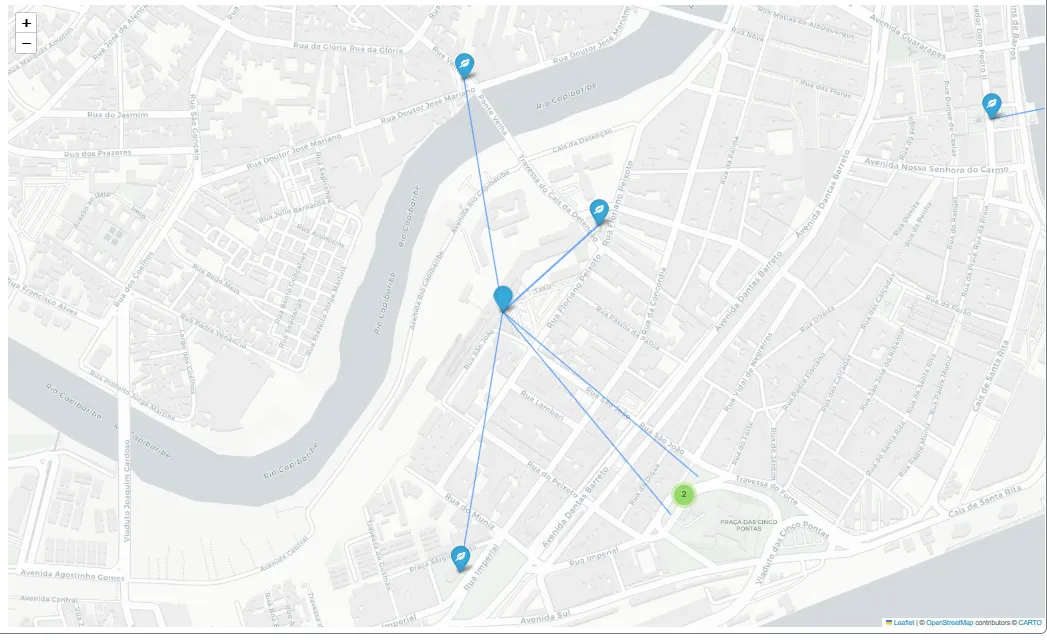
Já o GraphRAG, a visualização inclui também as arestas, as linhas são desenhadas entre os POIs, os quais passam pela restrição de proximidade e ilustrando assim as distâncias.
def show_subgraph(df_ev, edges, title="Subgrafo GraphRAG Ambiental",
                  center=None, zoom=16, max_nodes=80, max_edges=200):
    if df_ev.empty or "osm_id" not in df_ev.columns:
        print(f"[show_subgraph] Nenhuma evidência para exibir: '{title}'")
        return None

    nodes = df_ev.head(max_nodes).copy()
    nodes["osm_id"] = nodes["osm_id"].astype(int)
    idx = {int(r.osm_id): (float(r.lat), float(r.lon), str(r.amenity), r.name or "sem nome")
           for r in nodes.itertuples(index=False)}

    if center is None:
        lats = [v[0] for v in idx.values()]
        lons = [v[1] for v in idx.values()]
        center = (sum(lats) / len(lats), sum(lons) / len(lons))

    m = folium.Map(location=list(center), zoom_start=zoom, tiles="cartodbpositron")
    folium.map.Marker(
        list(center),
        icon=folium.DivIcon(html=(
            f'{title}'
        ))
    ).add_to(m)

    cl = MarkerCluster().add_to(m)
    for oid, (lat, lon, amenity, name) in idx.items():
        folium.Marker(
            location=[lat, lon],
            popup=f"{amenity} | {name} | POI {oid}",
            icon=folium.Icon(icon=ICON_MAP.get(amenity, "ok-sign"))
        ).add_to(cl)

    drawn = 0
    for a, b, d, rel in edges:
        if drawn >= max_edges:
            break
        a, b = int(a), int(b)
        if a not in idx or b not in idx:
            continue
        lat1, lon1, *_ = idx[a]
        lat2, lon2, *_ = idx[b]
        w = 5 if float(d) <= 150 else 3 if float(d) <= 300 else 2
        folium.PolyLine(
            locations=[[lat1, lon1], [lat2, lon2]],
            weight=w, opacity=0.65,
            tooltip=f"{rel}: {a}→{b} | {float(d):.1f}m"
        ).add_to(m)
        drawn += 1

    m.fit_bounds([[min(v[0] for v in idx.values()), min(v[1] for v in idx.values())],
                  [max(v[0] for v in idx.values()), max(v[1] for v in idx.values())]])
    return m
Experimento comparativo e avaliação
Para realizar o experimento, vamos utilizar perguntas explicitamente relacionais. Elas envolvem explicitamente a proximidade entre categorias, exigindo mais do que simples recuperação temática. O objetivo é observar como cada abordagem responde quando a pergunta depende de vínculo verificável entre entidades.
Para cada pergunta, vamos executar o baseline vetorial e o GraphRAG, não apenas registando os textos das respostas. Também vamos realizar o armazeno os IDs, as zonas ranqueadas, os pares encontrados e o subconjunto de evidência utilizado na geração. Dessa forma, a comparação não se limita à qualidade narrativa. Ela considera o que cada método efetivamente recupera e com que sustentação estrutural.
As perguntas utilizadas no teste são as seguintes com tema de levantamento e análise de estruturas ambientais:
TEST_QUERIES = [
    "Há integração entre áreas verdes e infraestrutura de reciclagem neste território?",
    "Quais zonas apresentam ativos hídricos próximos a áreas de lazer (até 800 metros)?",
    "Existem concentrações de infraestrutura de descarte próximas a ativos hídricos?",
    "Quais áreas apresentam sinergia entre parques e reciclagem? Cite evidências territoriais.",
]
Perguntas prostas para o teste, proximo passo é executar para ambas as abordagens para cada pergunta e consolido os resultados em uma estrutura comparável, que inclui respostas textuais e evidências recuperadas:
rows = []
for q in TEST_QUERIES:
    base_ans, base_top                    = baseline_answer(q, k=14)
    graph_ans, qobj, zones, df_ev, edges  = graphrag_answer(q)
    rows.append({
        "query":            q,
        "baseline_answer":  base_ans,
        "graphrag_answer":  graph_ans,
        "baseline_top_ids": [x[0] for x in base_top[:8]],
        "graphrag_ev_ids":  df_ev["osm_id"].head(12).tolist() if "osm_id" in df_ev.columns else [],
        "zones_top":        [z[0] for z in zones[:5]],
        "edges":            edges,
        "df_ev":            df_ev,
    })

df_compare = pd.DataFrame(rows)
df_compare.head()
| query | baseline_answer | graphrag_answer | baseline_top_ids | graphrag_ev_ids | zones_top | edges | df_ev |
|---|---|---|---|---|---|---|---|
| Há integração entre áreas verdes e infraestrutura de reciclagem neste território? | Sim, há integração entre áreas verdes e infraestrutura de reciclagem neste território. Várias zonas possuem parques próximos a pontos de reciclagem, com distâncias que variam de 34.4 metros a 498.5 metros. | Sim, há integração entre áreas verdes e infraestrutura de reciclagem neste território. | [12920110239, 5792360470, 678531198, 660899644, 607806652, 12519405586, 660889443, 667128528] | [12519405586, 242165865, 673508120, 12920110239, 666315850, 666315851, 666323889, 666323891, 666323892, 666323893, 666323894, 666504517] | [878183995ffffff, 878183998ffffff, 878183983ffffff, 87818399cffffff, 878183986ffffff] | (666315850, 678531198, 341.1171043269651, NEAR(park,recycling)) | osm_type | osm_id | amenity ... |
| Quais zonas apresentam ativos hídricos próximos a áreas de lazer (até 800 metros)? | As zonas que apresentam ativos hídricos próximos a áreas de lazer (até 800 metros) são: Zona 878183981ffffff com distâncias de 259.5m a 712.2m. | As zonas que apresentam ativos hídricos próximos a áreas de lazer são: 878183981ffffff. | [8319557555, 544598870, 660902380, 678541451, 655717658, 854786879, 673243750, 660886154] | [673223374, 673223375, 673504760, 8319557555, 199886985, 446100758] | [87818399effffff, 878183984ffffff, 8781839b1ffffff, 878183980ffffff, 87818398effffff] | (8319557555, 446100758, 259.51782203347364, NEAR(water_point,park)) | osm_type | osm_id | amenity ... |
| Existem concentrações de infraestrutura de descarte próximas a ativos hídricos? | Com base nas informações fornecidas, existem concentrações de infraestrutura de descarte (waste_disposal) nas zonas 878183983ffffff, 87818399cffffff e 878183998ffffff. | Existem concentrações de waste_disposal próximas a ativos hídricos. | [1023718706, 1024258938, 1023700587, 1023664089, 8319557555, 5792360470, 12920110239, 678531198] | [] | [878183986ffffff, 878183983ffffff, 878183981ffffff, 878183980ffffff, 878183982ffffff] | [] | Empty DataFrame |
| Quais áreas apresentam sinergia entre parques e reciclagem? Cite evidências territoriais. | As áreas que apresentam sinergia entre parques e reciclagem são: Zona 878183995ffffff (10 parques, 1 reciclagem); Zona 87818399cffffff (30 parques, 1 reciclagem); Zona 878183983ffffff (30 parques, 1 reciclagem). | As áreas com sinergia incluem 878183995ffffff, 87818399cffffff e 878183983ffffff. | [580584425, 377386145, 666323894, 128476663, 128476662, 662611662, 128476682, 1318429777] | [12519405586, 242165865, 673508120, 582306392, 1037707118, 1037707119, 12920110239, 666315850, 666315851, 666323889, 666323891, 666323892] | [878183998ffffff, 878183995ffffff, 87818399cffffff, 878183983ffffff, 878183984ffffff] | (367630671, 5792360470, 418.04369139438927, NEAR(park,recycling)) | osm_type | osm_id | amenity ... |
Nos testes realizados com essas perguntas, a diferença entre as abordagens fica clara. Em alguns casos, o baseline vetorial retorna itens semanticamente coerentes com o tema da consulta, mas não apresenta pares explícitos que comprovem a relação solicitada. A conexão entre os elementos aparece no texto, mas não está necessariamente sustentada por evidência estrutural.
Já o GraphRAG tende a produzir respostas mais ancoradas em vínculos verificáveis. Mesmo quando o texto é mais conciso, ele vem acompanhado de pares com distância mensurável e identificação das zonas envolvidas. Isso torna a resposta mais auditável, pois permite rastrear exatamente quais entidades foram conectadas e sob qual critério espacial.
Também realizo testes unitários pontuais para inspecionar o comportamento de cada abordagem isoladamente. Por exemplo, ao perguntar quais pontos de reciclagem ficam perto de parques, posso visualizar o resultado do baseline em texto e, no caso do GraphRAG, inspecionar o subgrafo gerado no mapa:
ans_base, top_base = baseline_answer(
    "Quais pontos de reciclagem ficam perto de parques?"
)

display(show_baseline_on_map(top_base, title="Baseline - Reciclagem e Parques"))
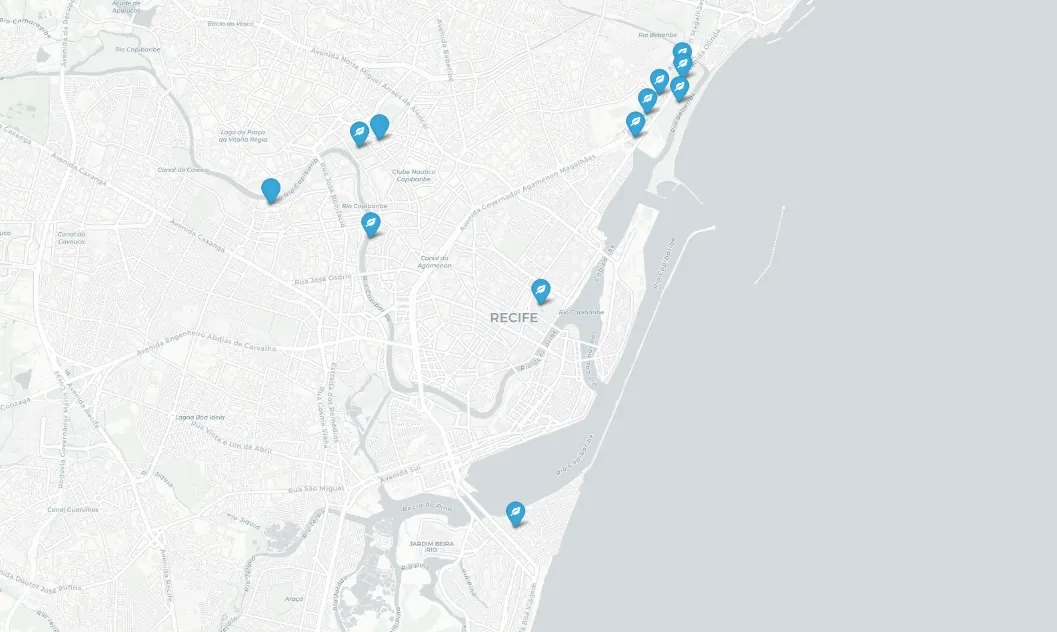
ans_g, qobj, zones, df_ev, edges = graphrag_answer(
    "Quais pontos de reciclagem ficam perto de parques?"
)
display(show_subgraph(df_ev, edges, title="Diagnóstico Territorial: Integração entre Reciclagem e Áreas Verdes"))
Para garantir uma avaliação repetível e estruturada, precisamos configurar um LLM para atuar como juiz, utilizando um schema explícito de validação. Esse juiz mede critérios como groundedness (grau de fundamentação no contexto fornecido) e aderência às restrições, por exemplo, responder exclusivamente com base no contexto disponibilizado e citar corretamente os IDs relevantes.
Embora essa abordagem não substitua a revisão humana, ela permite identificar padrões, inconsistências e desvios iniciais de forma sistemática e escalável.
JUDGE_SCHEMA = {
    "type": "object",
    "additionalProperties": False,
    "properties": {
        "groundedness":        {"type": "integer", "minimum": 1, "maximum": 5},
        "constraint_following":{"type": "integer", "minimum": 1, "maximum": 5},
        "notes":               {"type": "string"},
    },
    "required": ["groundedness", "constraint_following", "notes"],
}

def judge(query, answer, evidence_ids):
    prompt = (
        "Avalie a resposta de um assistente geoespacial e retorne JSON válido "
        f"com este schema: {json.dumps(JUDGE_SCHEMA)}\n\n"
        f"Pergunta: {query}\n\n"
        f"Resposta:\n{answer}\n\n"
        f"Evidências (IDs de POIs recuperados):\n{evidence_ids}\n\n"
        "Critérios:\n"
        "- groundedness: 1..5 (resposta parece baseada nas evidências)\n"
        "- constraint_following: 1..5 (cita IDs, respeita 'somente contexto')\n"
        "- notes: 1-3 frases\n"
        "Responda SOMENTE com JSON, sem markdown."
    )
    raw = llm_text(prompt)
    raw = raw.replace("```json", "").replace("```", "").strip()
    return json.loads(raw)
Vamos chamar o juiz que vai medir e verificar a aderência das respostas.
scores = []
for r in rows:
    s_base  = judge(r["query"], r["baseline_answer"], r["baseline_top_ids"])
    s_graph = judge(r["query"], r["graphrag_answer"],  r["graphrag_ev_ids"])
    scores.append({
        "query":                    r["query"],
        "baseline_groundedness":    s_base["groundedness"],
        "baseline_constraints":     s_base["constraint_following"],
        "baseline_notes":           s_base["notes"],
        "graphrag_groundedness":    s_graph["groundedness"],
        "graphrag_constraints":     s_graph["constraint_following"],
        "graphrag_notes":           s_graph["notes"],
    })

df_scores = pd.DataFrame(scores)
display(df_scores[[
    "query",
    "baseline_groundedness", "baseline_constraints",
    "graphrag_groundedness",  "graphrag_constraints",
]])

# médias por método
print("\nMédias:")
print(f"  Baseline: groundedness: {df_scores['baseline_groundedness'].mean():.2f} | constraints: {df_scores['baseline_constraints'].mean():.2f}")
print(f"  GraphRAG: groundedness: {df_scores['graphrag_groundedness'].mean():.2f} | constraints: {df_scores['graphrag_constraints'].mean():.2f}")
| query | baseline_groundedness | baseline_constraints | graphrag_groundedness | graphrag_constraints |
|---|---|---|---|---|
| 0 | 4 | 5 | 5 | 5 |
| 1 | 3 | 4 | 5 | 5 |
| 2 | 4 | 5 | 4 | 4 |
| 3 | 5 | 5 | 5 | 5 |
A avaliação pelo juiz LLM mostra que o GraphRAG obteve médias iguais ou superiores às do baseline: groundedness de 4.75 contra 4.00 e aderência a restrições de 4.75 nos dois métodos. O baseline oscilou mais entre as consultas (na consulta 1, por exemplo, ficou com 3 em groundedness), enquanto o GraphRAG manteve notas altas na maior parte delas, o que indica boa coerência textual, citação adequada de IDs e respeito às instruções do prompt.
No entanto, essa métrica avalia alinhamento entre resposta e contexto fornecido, e não a qualidade estrutural das relações recuperadas. O GraphRAG pode ter notas menores quando retorna respostas mais conservadoras ou evidencia limitações explícitas de cobertura, como na consulta 2. Além disso, ele oferece vínculos verificáveis e distâncias mensuráveis, algo que o juiz textual não captura completamente. Por isso, a análise precisa ser complementada por métricas relacionais, que avaliam a recuperação efetiva das relações pedidas.
Métrica relacional com precisão e cobertura
Como o objetivo do GraphRAG é recuperar relações, a avaliação vamos precisar verificar se os pares retornados realmente correspondem a relações válidas no grafo. Para isso, vamos precisar definir duas funções centrais para para a comparação, ground_truth_pairs e relational_accuracy.
A função ground_truth_pairs constrói o conjunto de referência para cada combinação de categorias e raio definida na consulta. Ela percorre as arestas NEAR já existentes no grafo e filtra apenas aquelas que conectam dois POIs das categorias solicitadas e que respeitam a distância máxima. O resultado é um conjunto de pares únicos de IDs que representa todas as relações válidas no território para aquela restrição. Esse conjunto funciona como verdade operacional independente do processo de recuperação por embeddings.
def ground_truth_pairs(near_pairs_def, radius_m=500):

    gt = set()
    for u, v, data in G.edges(data=True):
        if data.get("etype") != "NEAR":
            continue
        d = data.get("dist_m", 9999)
        if d > radius_m:
            continue
        # extrai tipo de cada nó
        u_data = G.nodes[u]; v_data = G.nodes[v]
        if u_data.get("ntype") != "POI" or v_data.get("ntype") != "POI":
            continue
        for p in near_pairs_def:
            conds = [
                (u_data.get("amenity") == p["a"] and v_data.get("amenity") == p["b"]),
                (u_data.get("amenity") == p["b"] and v_data.get("amenity") == p["a"]),
            ]
            if any(conds) and d <= p["radius_m"]:
                uid = int(u.split(":")[1]); vid = int(v.split(":")[1])
                gt.add((min(uid, vid), max(uid, vid)))
    return gt
Em seguida, a função relational_accuracy compara os pares efetivamente recuperados pelo GraphRAG com esse conjunto de referência. A partir dessa comparação, calcula precision, recall e F1. A precision mede quantos dos pares recuperados são de fato válidos. O recall mede quantos dos pares válidos existentes foram encontrados. O F1 equilibra os dois, oferecendo uma visão sintética do desempenho relacional.
def relational_accuracy(retrieved_edges, gt_pairs):
    """
    Precision  = pares recuperados que estão no GT / total recuperados
    Recall     = pares recuperados que estão no GT / total no GT
    F1         = média harmônica
    """
    if not retrieved_edges or not gt_pairs:
        return {"precision": 0.0, "recall": 0.0, "f1": 0.0,
                "tp": 0, "retrieved": len(retrieved_edges), "gt_size": len(gt_pairs)}

    retrieved_norm = {(min(int(a), int(b)), max(int(a), int(b)))
                      for a, b, *_ in retrieved_edges}
    tp = len(retrieved_norm & gt_pairs)
    precision = tp / len(retrieved_norm) if retrieved_norm else 0.0
    recall    = tp / len(gt_pairs)       if gt_pairs    else 0.0
    f1 = (2 * precision * recall / (precision + recall)
          if (precision + recall) > 0 else 0.0)
    return {
        "precision": round(precision, 4),
        "recall":    round(recall,    4),
        "f1":        round(f1,        4),
        "tp":        tp,
        "retrieved": len(retrieved_norm),
        "gt_size":   len(gt_pairs),
    }
Vamos agora aplicar nos testes e calcular as métricas.
NEAR_PAIRS_DEFAULT = [{"a": a, "b": b, "radius_m": RADIUS_M}
                      for a in AMENITIES for b in AMENITIES if a < b]

ras_rows = []
for q in TEST_QUERIES:
    ans_g, qobj, zones, df_ev, edges = graphrag_answer(q)

    near_pairs = qobj.get("near_pairs") or NEAR_PAIRS_DEFAULT
    gt   = ground_truth_pairs(near_pairs, radius_m=max((p["radius_m"] for p in near_pairs), default=MAX_NEAR_M))
    ras  = relational_accuracy(edges, gt)

    ras_rows.append({"query": q[:60] + "...", **ras})

df_ras = pd.DataFrame(ras_rows)
print("\nRELATIONAL ACCURACY SCORE ")
display(df_ras[["query", "precision", "recall", "f1", "tp", "retrieved", "gt_size"]])

print("\nMédias")
print(df_ras[["precision", "recall", "f1"]].mean().round(4).to_string())
| query | precision | recall | f1 | tp | retrieved | gt_size |
|---|---|---|---|---|---|---|
| 0 | 0.7714 | 0.8438 | 0.8060 | 27 | 35 | 32 |
| 1 | 0.4000 | 1.0000 | 0.5714 | 2 | 5 | 2 |
| 2 | 0.0000 | 0.0000 | 0.0000 | 0 | 0 | 0 |
| 3 | 0.7714 | 0.8438 | 0.8060 | 27 | 35 | 32 |
Os resultados mostram comportamentos distintos entre as consultas. Nas consultas 0 e 3, observa-se um bom equilíbrio entre precision e recall, com F1 de 0.8060 em ambas. Isso indica que o sistema conseguiu recuperar majoritariamente relações corretas, mantendo cobertura satisfatória do conjunto de referência, com 27 de 32 relações válidas identificadas em cada uma. Nesses casos, há consistência entre o que existe no grafo e o que foi efetivamente recuperado.
Na consulta 1, o cenário é diferente. O recall é 1.0, o que significa que todas as relações relevantes foram encontradas. No entanto, a precision é 0.4, evidenciando que uma parcela significativa dos pares retornados não pertence ao conjunto válido. O sistema foi abrangente, mas introduziu ruído ao incluir relações que não satisfazem estritamente a restrição definida.
A consulta 2 apresenta F1 igual a 0, mas com gt_size igual a 0, o que indica ausência de relações esperadas no território para aquela combinação de categorias e raio. Nesse caso, o resultado é semanticamente neutro, pois não havia relações a serem recuperadas. O valor zero decorre da definição matemática das métricas, não de um erro de recuperação.
Já as médias dos resultados, tivemos precision 0.4857, recall 0.6719 e F1 0.5459 mostram que o sistema tende a recuperar boa parte das relações relevantes, com recall superior à precision. Isso sugere uma estratégia mais sensível do que específica. Há boa capacidade de cobertura, mas ainda com ruído considerável, indicando espaço para melhorias.
Considerações finais
O baseline que é o RAG vetorial é eficiente, simples e de menor custo computacional. Ele funciona bem para perguntas descritivas ou de listagem, nas quais a similaridade semântica é suficiente para recuperar entidades relevantes. Sua principal limitação surge quando a consulta exige vínculos verificáveis, como proximidade ou integração, pois pode retornar itens corretos de forma isolada, deixando para o LLM a tarefa de inferir conexões que não estão explicitamente sustentadas.
Por outro lado, GraphRAG adiciona uma camada estrutural ao processo de recuperação. Ao operar sobre zonas e construir pares com distância mensurável, ele transforma restrições da pergunta em evidências, aumentando rastreabilidade. No final, o teste para mim deixou claro os dois métodos não competem diretamente, mas respondem melhor a problemas diferentes. Quando a pergunta é relacional e exige prova de vínculo, a abordagem usando grafo tende a ser mais adequada. Quando a tarefa é predominantemente descritiva e o custo precisa ser reduzido, com certeza vale muito mais utilizar o RAG vetorial.