Além da Latitude e Longitude: Criando Embeddings Espaciais para RAG

Quando comecei a misturar modelos de linguagem (LLMs) com dados geográficos, a primeira tentação foi tratar latitude e longitude como “apenas mais duas features” e seguir adiante. Logo percebi o problema, coordenadas são ótimas, mas não capturam contexto. Latitude e longitude não dizem nada sobre vizinhança. Elas não capturam bem a noção de vizinhança, não funcionam como identidades discretas e não oferecem uma estrutura hierárquica clara, como bairro, rua e quarteirão, dificultando então fazer essa conexão.
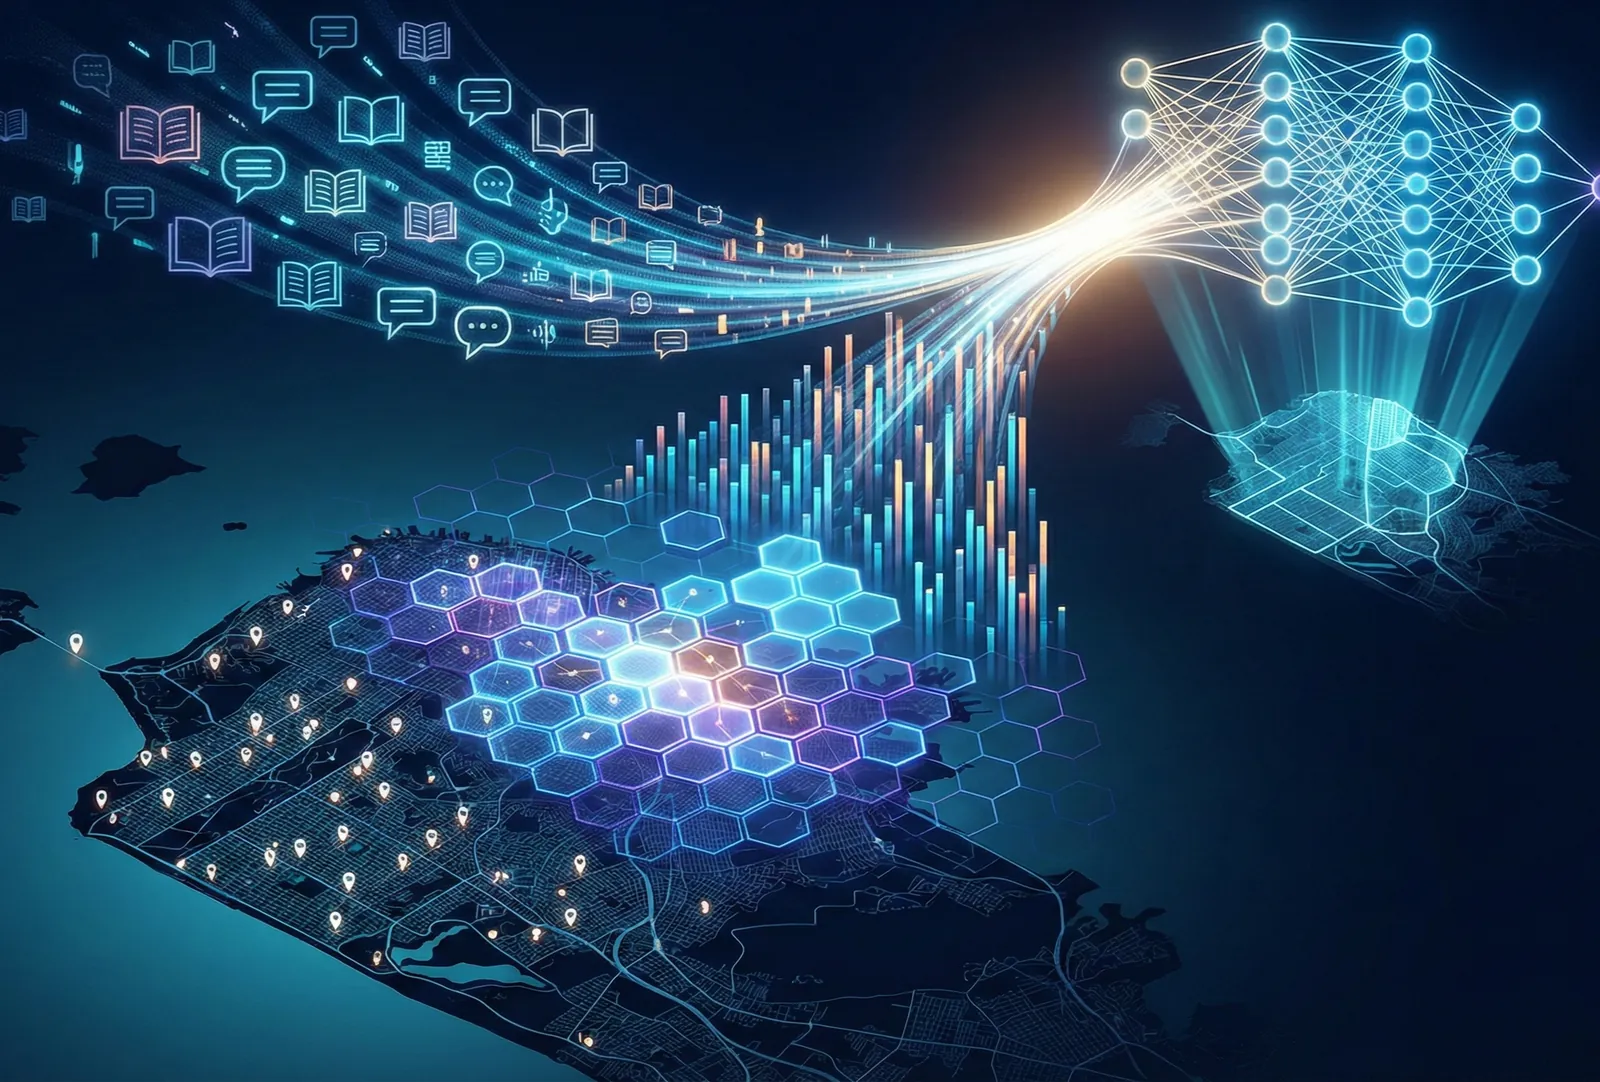
Neste artigo, compartilho um caminho simples e prático para transformar localização em algo que se comporte como um embedding, isto é, uma representação vetorial que pode ser indexada, comparada e utilizada em retrieval. O melhor é que esse processo é totalmente determinístico, não exige treinamento, tem baixo custo e escala bem. Para isso, vamos usar o H3, biblioteca de indexação espacial criada pela Uber, muito usada quando fazemos operações e análise de camadas vetoriais.
Definindo o recorte: o Recife como exemplo
Para tornar a explicação mais concreta, escolhi trabalhar com um recorte do Recife e pontos de interesse do OpenStreetMap (OSM). A partir desse conjunto, construí um retrieval geográfico básico e, em seguida, dei o passo para combinar geografia e texto e criar uma base consistente de RAG geográfico, algo que uma LLM consegue utilizar de forma eficaz.
Antes de buscar os dados, foi necessário definir o universo do experimento. Em geoprocessamento, isso é mais relevante do que parece, pois o recorte influencia a densidade, os tipos de lugares e até o comportamento do retrieval. No meu caso, defini um bounding box aproximado do Recife.
# Recife
SOUTH, WEST, NORTH, EAST = -8.15, -35.02, -7.95, -34.85
Com o recorte estabelecido, consultei os pontos do OSM por meio da Overpass API. Selecionei categorias comuns em ambientes urbanos, como hospital, escola, farmácia, polícia e abrigo. Essas classes são fáceis de validar e representam bem a dinâmica da cidade. Assim, obtive um dataset realista e, ao mesmo tempo, interpretável.
import requests, pandas as pd

OVERPASS_URL = "https://overpass-api.de/api/interpreter"
AMENITIES = ["hospital", "school", "pharmacy", "police", "shelter"]

query = f"""
[out:json][timeout:60];
(
  node["amenity"~"^({'|'.join(AMENITIES)})$"]({SOUTH},{WEST},{NORTH},{EAST});
);
out center;
"""

resp = requests.post(OVERPASS_URL, data=query)
data = resp.json()
len(data["elements"])
1250
Estruturando os dados para indexação
Com os dados coletados, organizei tudo em um formato simples de indexar e depurar, gerando um DataFrame com colunas essenciais, como id, nome, categoria, latitude e longitude. Parece bobagem, mas esse passo facilita muito depois. Principalmente quando você quer evoluir o pipeline, por exemplo, ao trocar node por way ou relation e utilizar center no lugar das coordenadas diretas.
rows = []
for el in data["elements"]:
    tags = el.get("tags", {})
    amenity = tags.get("amenity")
    name = tags.get("name", None)

    if el["type"] == "node":
        lat, lon = el.get("lat"), el.get("lon")
    else:
        center = el.get("center", {})
        lat, lon = center.get("lat"), center.get("lon")

    rows.append({
        "osm_type": el["type"],
        "osm_id": el["id"],
        "name": name,
        "category": amenity,
        "lat": lat,
        "lon": lon
    })

df = pd.DataFrame(rows)
df.head()
| Index | OSM Type | OSM ID | Nome | Categoria | Latitude | Longitude |
|---|---|---|---|---|---|---|
| 0 | node | 560397916 | - | pharmacy | -8.0624473 | -34.8964475 |
| 1 | node | 560398646 | Colégio GGE | school | -8.0620287 | -34.8987418 |
| 2 | node | 560400267 | Delegacia de Polícia Civil | police | -8.0458839 | -34.9275611 |
| 3 | node | 560628925 | Colégio Sancarlos | school | -8.0477011 | -34.9282542 |
| 4 | node | 561522263 | Colégio Souza Leão | school | -8.0541609 | -34.9198574 |
Ao analisar a distribuição das classes, observei que as escolas predominam no conjunto. Isso é positivo, pois cria uma situação próxima da realidade. Ao buscar uma classe como hospital, não quero receber escolas próximas apenas porque são maioria. Em outras palavras, o retrieval precisa compreender intenção, e não apenas densidade.
df["category"].value_counts()
| Categoria | Quantidade |
|---|---|
| school | 720 |
| hospital | 193 |
| pharmacy | 158 |
| shelter | 105 |
| police | 74 |
Até aqui, eu tinha apenas um conjunto de pontos com latitude e longitude. A partir deste ponto, vem a mudança central, no qual iremos tratar as coordenadas como números contínuos e convertê-las em tokens espaciais com o H3.
Convertendo coordenadas em tokens espaciais com H3
!pip install h3
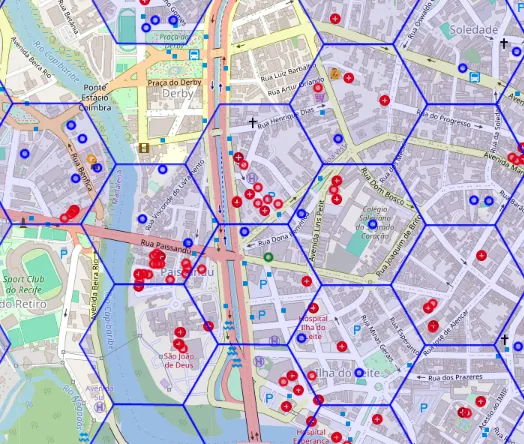
A ideia principal do H3 é dividir o mapa em hexágonos e atribuir um identificador único a cada célula, como na imagem ao lado. Para a LLM, esse identificador funciona como um token espacial.
Para utilizar esse índice, é possível escolher diferentes resoluções, representando o espaço em múltiplas escalas. Utilizei as resoluções 7, 9 e 11 para capturar desde regiões mais amplas até detalhes locais.
import h3

def add_h3(df: pd.DataFrame, res: int) -> pd.DataFrame:
    out = df.copy()
    out[f"h3_r{res}"] = [
        h3.latlng_to_cell(lat, lon, res) for lat, lon in zip(out["lat"], out["lon"])
    ]
    return out

df = add_h3(df, 7)
df = add_h3(df, 9)
df = add_h3(df, 11)
df[["lat","lon","h3_r7","h3_r9","h3_r11"]].head()
| Index | Latitude | Longitude | H3 R7 | H3 R9 | H3 R11 |
|---|---|---|---|---|---|
| 0 | -8.0624473 | -34.8964475 | 878183980ffffff | 89818398053ffff | 8b818398051cfff |
| 1 | -8.0620287 | -34.8987418 | 878183980ffffff | 89818398057ffff | 8b8183980573fff |
| 2 | -8.0458839 | -34.9275611 | 878183981ffffff | 8981839810fffff | 8b81839810ebfff |
| 3 | -8.0477011 | -34.9282542 | 878183981ffffff | 89818398107ffff | 8b8183981050fff |
| 4 | -8.0541609 | -34.9198574 | 878183981ffffff | 898183981cfffff | 8b8183981cf5fff |
A partir daqui cada local deixa de ser apenas um ponto somente e passa a ser representado por um conjunto de identificadores discretos. É nesse momento que o embedding começa a tomar forma, sem necessidade de treinar uma rede.
Lidando com o problema das bordas
No mundo real, bordas importam. Dois pontos podem estar muito próximos, mas cair em hexágonos diferentes. Se esses hexágonos forem tratados como completamente distintos, o retrieval tende a falhar justamente onde deveria acertar.
Para lidar com isso, adotei uma estratégia simples, além do token da célula principal, incluí também os tokens das células vizinhas. No H3, esse conjunto é chamado de k-ring, ou grid disk. Utilizei a resolução 9 como base urbana e k = 1 para incluir os vizinhos imediatos.
Primeiro, gerei uma assinatura multiescala. Em seguida, expandi essa assinatura com as células vizinhas. Assim, o conceito de “perto” deixa de se restringir à distância e passa a incorporar a adjacência topológica, o que melhora o desempenho em áreas densas.
RESOLUTIONS = (7, 9, 11)

def spatial_signature(lat: float, lon: float, resolutions=RESOLUTIONS):
    return [h3.latlng_to_cell(lat, lon, r) for r in resolutions]

df["sig"] = [spatial_signature(lat, lon) for lat, lon in zip(df["lat"], df["lon"])]

df["sig"].head()
sig
0 [878183980ffffff, 89818398053ffff, 8b818398051...
1 [878183980ffffff, 89818398057ffff, 8b818398057...
2 [878183981ffffff, 8981839810fffff, 8b81839810e...
3 [878183981ffffff, 89818398107ffff, 8b818398105...
4 [878183981ffffff, 898183981cfffff, 8b8183981cf...
E depois expande com vizinhos:
def sig_with_neighbors(sig, k=1):
    base = sig[1]  # r9
    nbrs = list(h3.grid_disk(base, k))
    return sig + nbrs

df["sig_k1"] = [sig_with_neighbors(s, k=1) for s in df["sig"]]
df["sig_k1"].head()
sig_k1
0 878183980ffffff
89818398053ffff
8b818398...
1 878183980ffffff
89818398057ffff
8b818398...
2 878183981ffffff
8981839810fffff
8b818398...
3 878183981ffffff
89818398107ffff
8b818398...
4 878183981ffffff
898183981cfffff
8b818398...
Convertendo tudo em vetores (hashing trick)
Com os tokens definidos, o passo seguinte foi convertê-los em vetores numéricos de dimensão fixa. Isso permite utilizar similaridade por cosseno, índices vetoriais como FAISS ou HNSW e, consequentemente, aplicar RAG.
Para essa conversão, utilizei o hashing trick, onde cada token é mapeado para uma posição do vetor por meio de uma função hash, no caso MD5, acumulando contagens nessa posição. Ao final, normalizo o vetor. O resultado foi um conjunto de 1.250 locais do Recife convertidos em vetores prontos para retrieval.
import numpy as np, hashlib

def hash_to_idx(token: str, dim: int) -> int:
    h = hashlib.md5(token.encode("utf-8")).hexdigest()
    return int(h, 16) % dim

def tokens_to_vec(tokens, dim=1024):
    v = np.zeros(dim, dtype=np.float32)
    for t in tokens:
        v[hash_to_idx(t, dim)] += 1.0
    n = np.linalg.norm(v)
    return v if n == 0 else (v / n)

DIM = 1024
V_geo = np.vstack([tokens_to_vec(toks, dim=DIM) for toks in df["sig_k1"].values])
V_geo.shape
(1250, 1024)
Visualizando o retrieval no mapa
Após transformar os pontos em vetores e estruturar o índice, busquei observar o comportamento espacial do sistema. Para isso, defini um ponto de consulta e visualizei no mapa quais locais o mecanismo de retrieval considerava mais próximos.
Utilizei uma função em Python com matplotlib:
def plot_retrieval(query_lat, query_lon, results, title="", margin=0.01):
    plt.figure(figsize=(10, 8))
    ax = plt.gca()

    # Calcular bounds da região de interesse
    all_lats = np.concatenate([results["lat"].values, [query_lat]])
    all_lons = np.concatenate([results["lon"].values, [query_lon]])

    lat_min, lat_max = all_lats.min() - margin, all_lats.max() + margin
    lon_min, lon_max = all_lons.min() - margin, all_lons.max() + margin

    # Filtrar pontos de contexto que estão na região visível
    context_mask = (
        (df["lat"] >= lat_min) & (df["lat"] <= lat_max) &
        (df["lon"] >= lon_min) & (df["lon"] <= lon_max)
    )
    context_df = df[context_mask]

    # Pontos de contexto (cinza claro, pequenos)
    ax.scatter(
        context_df["lon"].values,
        context_df["lat"].values,
        s=20,
        c='lightgray',
        alpha=0.5,
        label='Outros pontos na região',
        zorder=1
    )

    # Top-k retornado (azul, médios)
    ax.scatter(
        results["lon"].values,
        results["lat"].values,
        s=100,
        c='royalblue',
        edgecolors='darkblue',
        linewidths=1.5,
        label='Resultados (top-k)',
        zorder=3
    )

    # Ponto da query (vermelho, grande)
    ax.scatter(
        [query_lon],
        [query_lat],
        s=250,
        c='red',
        marker='*',
        edgecolors='darkred',
        linewidths=2,
        label='Query',
        zorder=4
    )

    # Linhas da query para cada resultado
    for _, r in results.iterrows():
        ax.plot(
            [query_lon, r["lon"]],
            [query_lat, r["lat"]],
            'b-',
            alpha=0.3,
            linewidth=1,
            zorder=2
        )

    # Definir limites do plot
    ax.set_xlim(lon_min, lon_max)
    ax.set_ylim(lat_min, lat_max)

    # Adicionar anotações para os top 3
    for i, row in results.head(3).iterrows():
        ax.annotate(
            f"{i+1}. {row['name'][:20] if pd.notna(row['name']) else row['category']}\n(score: {row['score']:.3f})",
            xy=(row['lon'], row['lat']),
            xytext=(10, 10),
            textcoords='offset points',
            fontsize=8,
            bbox=dict(boxstyle='round,pad=0.5', fc='yellow', alpha=0.7),
            arrowprops=dict(arrowstyle='->', connectionstyle='arc3,rad=0', lw=1)
        )

    ax.set_title(title, fontsize=12, fontweight='bold')
    ax.set_xlabel("Longitude", fontsize=10)
    ax.set_ylabel("Latitude", fontsize=10)
    ax.legend(loc='upper right', fontsize=9)
    ax.grid(True, alpha=0.3)

    # Aspect ratio igual para lat/lon
    ax.set_aspect('equal', adjustable='box')

    plt.tight_layout()
    plt.show()
Retrieval “perto de mim” similaridade vetorial
Retrieval é o processo de recuperar informações relevantes a partir de um conjunto de dados indexado. Em sistemas vetoriais, isso significa identificar os itens mais semelhantes a uma consulta com base em uma métrica, como similaridade por cosseno ou distância euclidiana.
Primeiro vamos criar o retrieve geográfico, para iniciar os testes de recuperação por proximidade, por meio do cálculo a similaridade em relação ao conjunto dos dados.
Essa abordagem não busca medir distâncias em metros com precisão absoluta (o que seria lento caso muitos pontos), o objetivo é oferecer uma noção prática de proximidade que seja rápida, passível de indexação e menos sensível a efeitos de borda. Em muitos contextos urbanos, esse nível de aproximação é suficiente, em especial casos de uso como "Qual hospital mais próximos dessa coordenada?".
from sklearn.metrics.pairwise import cosine_similarity

def retrieve_geo(query_lat, query_lon, topk=10):
    q_tokens = sig_with_neighbors(spatial_signature(query_lat, query_lon), k=1)
    q_vec = tokens_to_vec(q_tokens, dim=DIM).reshape(1, -1)

    sims = cosine_similarity(q_vec, V_geo).ravel()
    top = np.argsort(-sims)[:topk]

    out = df.iloc[top][["name", "category", "lat", "lon"]].copy()
    out["score"] = sims[top]
    return out.reset_index(drop=True)

query_lat = float(df.iloc[0].lat)
query_lon = float(df.iloc[0].lon)

res_geo = retrieve_geo(query_lat, query_lon, topk=10)
display(res_geo)

plot_retrieval(
    query_lat, query_lon, res_geo,
    title=f"Retrieval GEO | lat={query_lat:.6f}, lon={query_lon:.6f} | topk=10"
)
| Index | Name | Category | Latitude | Longitude | Score |
|---|---|---|---|---|---|
| 0 | - | pharmacy | -8.0624473 | -34.8964475 | 1.000000238418579 |
| 594 | Real Hospital Português | hospital | -8.0643955 | -34.8981574 | 0.9166668653488159 |
| 605 | Instituto Cervantes | school | -8.0617243 | -34.8971303 | 0.9166668653488159 |
| 603 | - | hospital | -8.0631268 | -34.8953544 | 0.9166668653488159 |
| 589 | - | hospital | -8.0627699 | -34.8983415 | 0.9166668653488159 |
| 584 | - | hospital | -8.0628958 | -34.898804 | 0.6172134876251221 |
| 1231 | Hospital Memorial São José | hospital | -8.0598305 | -34.8971396 | 0.5833334922790527 |
| 1 | colégio GGE | school | -8.0620287 | -34.8987418 | 0.5833334922790527 |
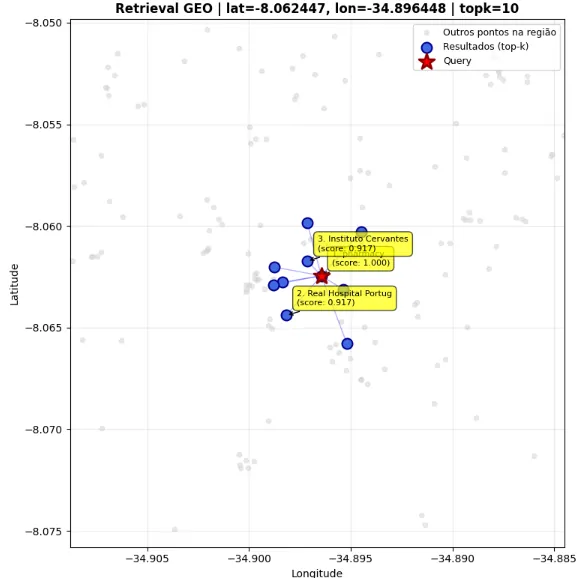
Obviamente, isso não é perfeito, veja que ela ainda selecionou algumas classes que não são hospitais. Além disso, caso um usuário fizesse a busca bem na divisa entre dois bairros, poderia rolar uma confusão. Mas na prática, esse é um processo que pode funcionar bem o suficiente para maioria dos casos do dia a dia.
Combinando texto e geografia: o passo que cria o RAG geográfico
Até aqui, eu respondia à pergunta “o que está perto desta coordenada?”. No entanto, a dúvida real do usuário costuma ser outra “quais hospitais estão perto de mim?”.
Para incorporar a intenção semântica à busca, gerei embeddings de texto a partir do nome e da categoria utilizando o modelo SentenceTransformer. Optei pelo modelo all-MiniLM-L6-v2, que para mim ofereceu equilíbrio entre desempenho e custo computacional, bem leve e funcionou bem na minha máquina. Em seguida, concatenei os embeddings o textual e o geográfico.
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("all-MiniLM-L6-v2")

texts = (df["name"].fillna("") + " " + df["category"].fillna("")).tolist()
V_txt = model.encode(texts, normalize_embeddings=True)

V_hybrid = np.hstack([V_txt, V_geo])
V_hybrid.shape
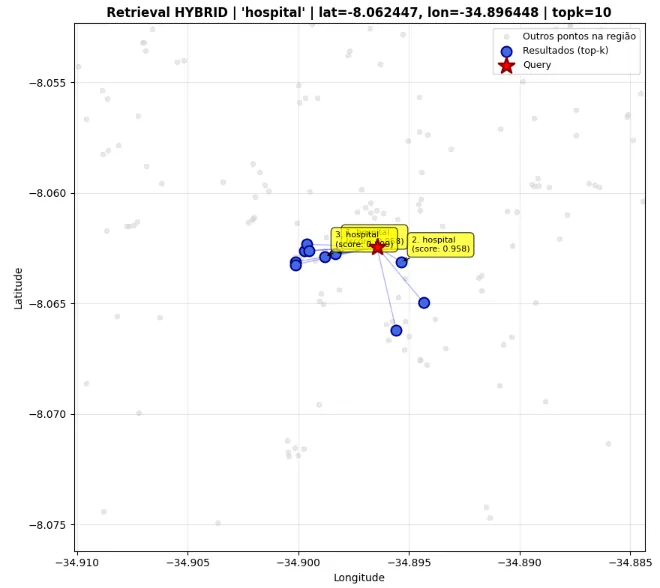
Quando analisei o resultado o ganho foi imediato. O sistema deixa de ser apenas geográfico e passa a considerar simultaneamente localização e intenção. Em vez de retornar qualquer ponto próximo, ele passa a priorizar o que está próximo e semanticamente alinhado à consulta.
Agora sim temos um RAG geográfico de verdade. O retriever seleciona o contexto mais adequado, e a LLM assume a etapa linguística, explicando, comparando ou recomendando com base nos resultados recuperados.
def retrieve_hybrid(query_text, query_lat, query_lon, topk=10):
    # texto
    q_txt = model.encode([query_text], normalize_embeddings=True)

    # geo
    q_tokens = sig_with_neighbors(spatial_signature(query_lat, query_lon), k=1)
    q_geo = tokens_to_vec(q_tokens, dim=DIM).reshape(1, -1)

    # concat
    q = np.hstack([q_txt, q_geo])

    sims = cosine_similarity(q, V_hybrid).ravel()
    top = np.argsort(-sims)[:topk]

    out = df.iloc[top][["name", "category", "lat", "lon"]].copy()
    out["score"] = sims[top]
    return out.reset_index(drop=True)

query_text = "hospital"

res_hybrid = retrieve_hybrid(query_text, query_lat, query_lon, topk=10)
display(res_hybrid)

plot_retrieval(
    query_lat, query_lon, res_hybrid,
    title=f"Retrieval HYBRID | '{query_text}' | lat={query_lat:.6f}, lon={query_lon:.6f} | topk=10"
)
| Index | Name | Category | Latitude | Longitude | Score |
|---|---|---|---|---|---|
| 589 | - | hospital | -8.0627699 | -34.8983415 | 0.9583333730697632 |
| 603 | - | hospital | -8.0631268 | -34.8953544 | 0.9583333730697632 |
| 584 | - | hospital | -8.0628958 | -34.898804 | 0.808606743812561 |
| 604 | - | hospital | -8.0649677 | -34.8943472 | 0.7916668057441711 |
| 597 | - | hospital | -8.0631409 | -34.9001382 | 0.7916668057441711 |
| 587 | - | hospital | -8.0626232 | -34.8997285 | 0.7916668057441711 |
| 636 | - | hospital | -8.0662101 | -34.895579 | 0.7916668057441711 |
| 672 | - | hospital | -8.0623306 | -34.8996346 | 0.7916668057441711 |
Conclusão
Aqui eu parti de uma limitação clara das coordenadas. Quando usadas isoladamente, latitude e longitude não representam adequadamente o contexto. Ao converter o espaço em tokens H3 multiescala, incorporar a adjacência com k-ring e transformar essas assinaturas em vetores por meio do hashing trick, construí um embedding geográfico simples, determinístico e eficiente. Esse processo dispensa treinamento, tem baixo custo computacional e escala de forma previsível.
O ponto mais relevante, porém, não é apenas técnico. Ao transformar a localização em uma representação vetorial compatível com mecanismos modernos de retrieval, passamos a tratar o espaço como parte da linguagem do sistema. A geografia deixa de ser um filtro externo e passa a integrar o próprio raciocínio do modelo.
Quando esse embedding é combinado a representações textuais geradas pelo SentenceTransformer, surge um retriever capaz de compreender simultaneamente o que se busca e onde se busca. Nesse estágio, o RAG geográfico deixa de ser uma adaptação pontual e passa a operar como uma arquitetura integrada, unindo localização e intenção semântica de forma prática e aplicável a contextos reais, da busca contextual urbana a sistemas inteligentes de apoio à decisão.
No fim, isso vai além de indexação espacial, é uma forma de fazer LLMs entenderem geografia de verdade, não só descreverem coordenadas, o que é um passo essencial para que LLMs deixem de apenas descrever o espaço e passem, de fato, a compreendê-lo.