Validação sem vazamento em séries temporais: um pixel de soja do Sentinel-2, avaliação sequencial e teste selado

Quando monto o protocolo de avaliação de uma previsão em séries de imagens de satélite, a primeira regra que escrevo não é sobre modelo. É sobre quando eu posso olhar o teste. Parece exagero, mas em séries temporais é muito fácil construir uma avaliação que mede a capacidade do modelo de espiar o futuro, e não de prevê-lo.
O problema é que esse tipo de erro não quebra nada. O código roda, a métrica sai bonita e o gráfico convence. O problema só aparece quando o modelo vai para produção e passa a receber, a cada dia, apenas o que já aconteceu. Em imagens de satélite ainda existe um agravante: as nuvens. A série chega cheia de buracos, e o jeito mais comum de tapá-los usa, sem ninguém perceber, observações do futuro.
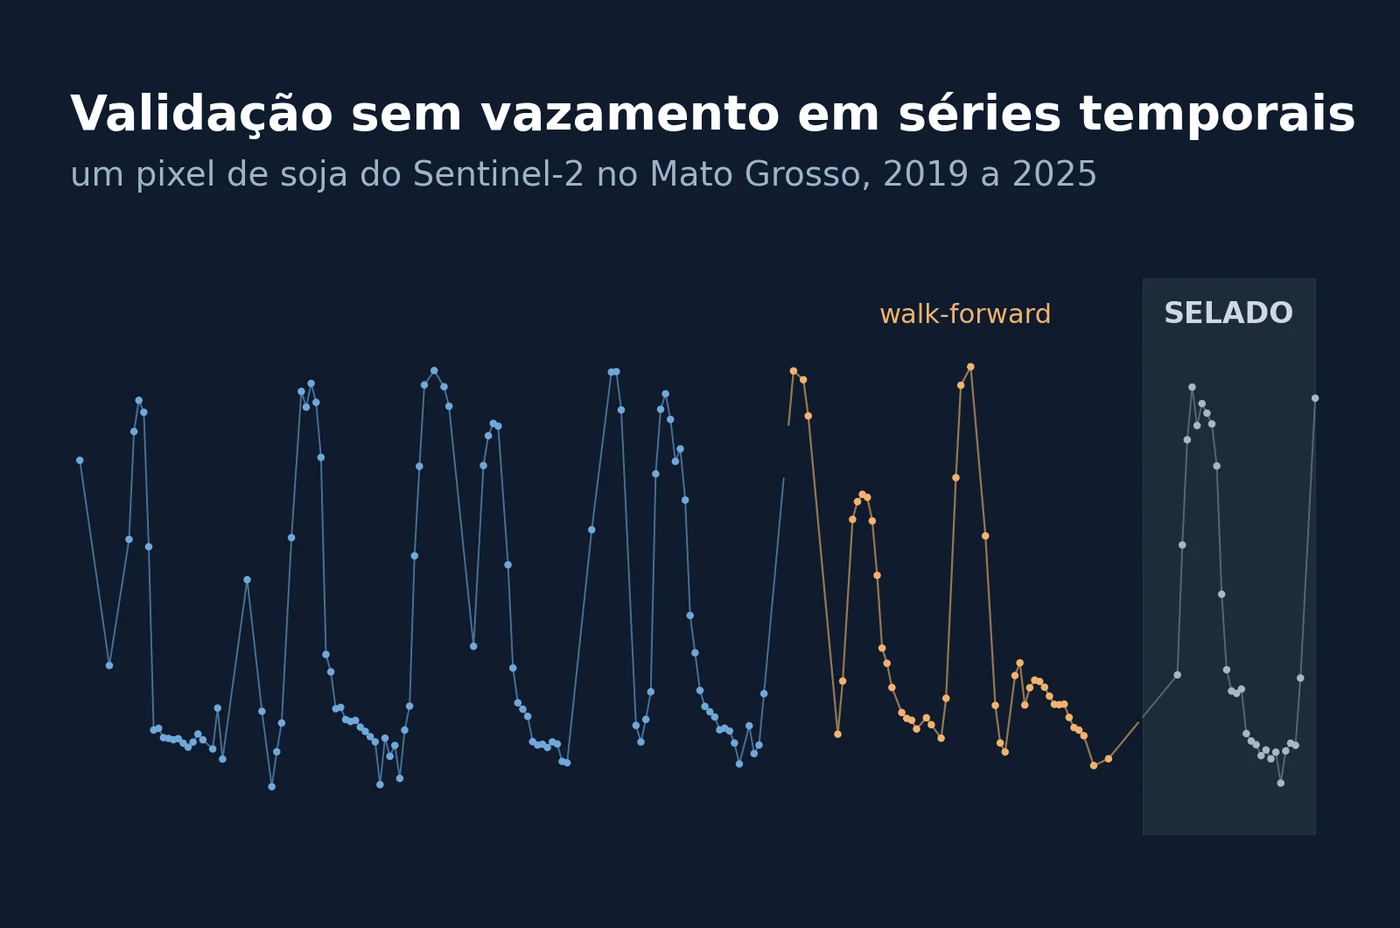
Neste artigo, compartilho o caminho que uso para avaliar previsões sem vazamento de informação (data leakage): avaliação sequencial (walk-forward), um período reservado para o teste final e uma métrica que permite comparar os modelos com uma referência simples. O experimento usa dados reais: um único pixel do Sentinel-2 dentro de um talhão de soja no Mato Grosso, de 2019 a 2025. O treino vai até 2022, a validação usa 2023 e 2024 e o teste fica em 2025. O treino serve para ajustar o modelo; a validação, para comparar as alternativas e escolher qual usar; o teste, para medir o desempenho da escolha em um período posterior.
Uso uma floresta aleatória (Random Forest, RF), um modelo que combina várias árvores de decisão para produzir a previsão. A configuração é simples de propósito, porque o assunto aqui é a forma de avaliar. Como vamos ver, uma avaliação com vazamento pode melhorar artificialmente a nota e até inverter a decisão sobre qual modelo usar.
Buscando as imagens no catálogo STAC
Escolhi um ponto numa área agrícola do Mato Grosso, em (-13,3752; -54,4755). Cada pixel é uma célula da imagem que representa uma pequena área no terreno. Antes de usar esse ponto, conferi no MapBiomas: o pixel é soja (classe 39) em 2017 e em 2023, e toda a janela de 7×7 pixels de 30 m ao redor também. Essa posição no interior da área classificada como soja reduz o risco de mistura com estradas ou com a borda do talhão. As imagens matriciais (rasters) do MapBiomas disponíveis para esta conferência são só desses dois anos, então não verifiquei os demais; a curva do índice de vegetação por diferença normalizada (NDVI), na figura 1, ajuda a examinar o calendário de crescimento, mas não confirma sozinha a cultura de cada ano.
A série vem do catálogo do Planetary Computer, pela coleção sentinel-2-l2a, de produtos de nível 2A do Sentinel-2. O catálogo segue o padrão STAC (SpatioTemporal Asset Catalog, catálogo de ativos espaço-temporais), que permite localizar imagens por área, data e outros metadados. Como queremos um único pixel, lemos apenas a região necessária de cada banda. Isso é possível porque os arquivos estão em GeoTIFF otimizado para acesso em nuvem (COG, Cloud Optimized GeoTIFF), um formato que permite buscar partes da imagem sem transferir o arquivo inteiro. São cerca de 1.800 requisições pequenas, três por cena.
from concurrent.futures import ThreadPoolExecutor

import pandas as pd
import numpy as np
import planetary_computer
import pystac_client
import rasterio
from rasterio.warp import transform
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import KFold

LAT, LON = -13.375151012548173, -54.47550071228342   # talhão de soja no MT (MapBiomas classe 39)

catalog = pystac_client.Client.open(
    "https://planetarycomputer.microsoft.com/api/stac/v1",
    modifier=planetary_computer.sign_inplace,
)
items = list(catalog.search(
    collections=["sentinel-2-l2a"],
    intersects={"type": "Point", "coordinates": [LON, LAT]},
    datetime="2019-01-01/2025-12-31",
).items())
print("cenas encontradas:", len(items))


def read_pixel(item):
    out = {"data": item.datetime.date(), "tile": item.properties["s2:mgrs_tile"],
           "baseline": item.properties.get("s2:processing_baseline")}
    for band in ["B04", "B08", "SCL"]:
        with rasterio.open(item.assets[band].href) as src:
            xs, ys = transform("EPSG:4326", src.crs, [LON], [LAT])
            r, c = src.index(xs[0], ys[0])
            out[band] = int(src.read(1, window=((r, r + 1), (c, c + 1)))[0, 0])
    return out


with ThreadPoolExecutor(16) as pool:
    rows = list(pool.map(read_pixel, items))
pd.DataFrame(rows).sort_values("data").to_csv("pixel_soja_s2.csv", index=False)
cenas encontradas: 597
As 597 cenas são todas da mesma quadrícula de referência (tile), identificada como 21LYF, e a transferência levou cerca de cinco minutos na minha máquina. Guardamos B04 (vermelho), B08 (infravermelho próximo) e a camada de classificação de cena (SCL, Scene Classification Layer), que indica se o pixel é vegetação, solo, nuvem ou sombra. Os dados, o cubo e os programas do artigo estão no repositório do blog no GitHub.
Calculando o NDVI: correção radiométrica, máscara de nuvem e cenas repetidas
Antes de calcular o NDVI, há três cuidados. Primeiro, algumas datas aparecem duas vezes por causa de reprocessamentos; ficamos com a versão de processamento mais recente, identificada nos dados como baseline. Segundo, precisamos converter o número digital (DN), o valor inteiro armazenado em cada banda, para a escala usada no cálculo. Nos arquivos deste experimento, aplicamos DN/10.000 antes da versão 04.00 e (DN − 1.000)/10.000 a partir dela. A subtração de 1.000 corrige o deslocamento aditivo (offset) introduzido nesses produtos. Essa regra depende da fonte e de como os arquivos foram publicados, por isso precisa ser conferida ao trocar os dados. Terceiro, aplicamos uma máscara de qualidade: só aceitamos o pixel quando a SCL indica vegetação (4) ou solo exposto (5).
Para conferir essa conversão, comparei uma cena de cada uma das sete versões de processamento presentes no arquivo. Nas bandas B04 e B08, os números digitais dos COGs coincidiram com os valores arquivados. Os arquivos XML, que organizam os metadados dos produtos, confirmaram o fator de quantificação de 10.000 e os deslocamentos usados. Os COGs consultados indicavam escala 1 e deslocamento 0 na leitura, portanto a conversão foi aplicada depois de ler os números digitais. Essa é uma conferência amostral, não uma validação de todas as cenas. O relatório radiométrico registra os itens e os endereços dos metadados oficiais.
df = pd.read_csv("pixel_soja_s2.csv", parse_dates=["data"])
df["baseline"] = pd.to_numeric(df["baseline"], errors="raise")
if not np.isfinite(df["baseline"]).all():
    raise ValueError("Baseline ausente ou inválida; confira os metadados antes de aplicar o offset.")
df = df.sort_values(["data", "baseline"]).drop_duplicates("data", keep="last")  # cena reprocessada: fica a mais nova
offset = np.where(df["baseline"] >= 4.0, 1000, 0)    # política radiométrica dos arquivos deste experimento
red = (df["B04"] - offset) / 10_000
nir = (df["B08"] - offset) / 10_000
df["ndvi"] = (nir - red) / (nir + red)
clean = df[df["SCL"].isin([4, 5])].set_index("data")["ndvi"]   # SCL 4 = vegetação, 5 = solo exposto
df_dev = df[df["data"] < pd.Timestamp("2025-01-01")]
clean_dev = clean[clean.index < pd.Timestamp("2025-01-01")]
print(f"até 2024: cenas {len(df_dev)} | limpas no pixel {len(clean_dev)}")
print("limpas por mês até 2024:", clean_dev.groupby(clean_dev.index.month).size().to_dict())
até 2024: cenas 421 | limpas no pixel 238
limpas por mês até 2024: {1: 11, 2: 8, 3: 11, 4: 22, 5: 25, 6: 33, 7: 34, 8: 34, 9: 26, 10: 16, 11: 11, 12: 7}
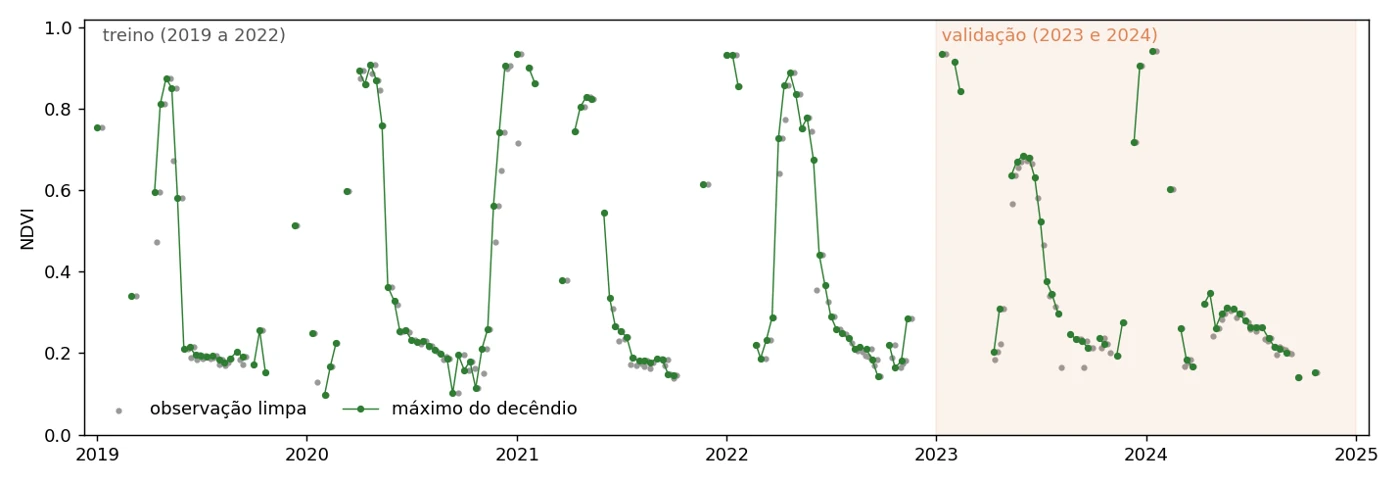
A curva mostra o NDVI subindo a partir de outubro e novembro, chegando perto de 0,9 entre dezembro e janeiro e caindo em fevereiro. Esse padrão é compatível com o calendário agrícola considerado para o ponto. Na maioria dos anos aparece outro ciclo de crescimento entre março e junho e, na seca, o NDVI fica perto de 0,2. Esse segundo ciclo muda de um ano para outro: em 2024 ele quase não aparece. A curva descreve a vegetação observada, sem identificar sozinha a cultura de cada ciclo.
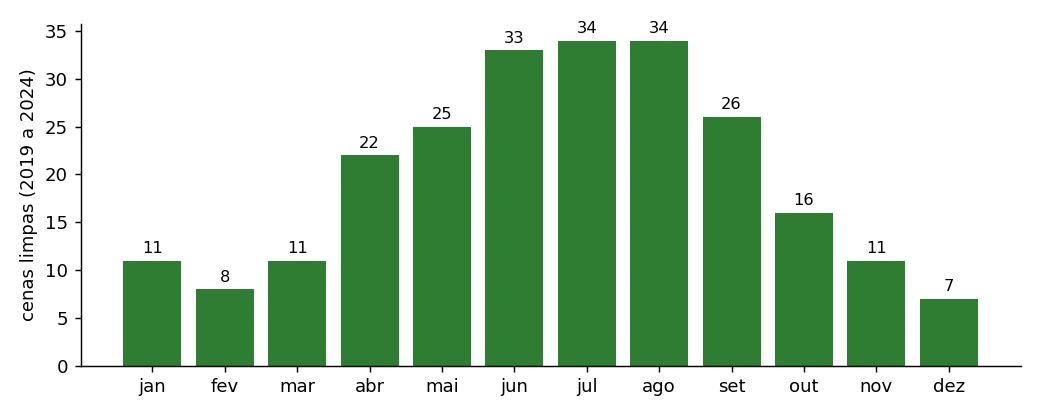
Só que a figura 2 mostra o problema que vai guiar o resto do artigo. As observações limpas são mais escassas justamente na safra. De 2019 a 2024, dezembro teve 7 cenas sem nuvem, contra 34 em julho. A previsão interessa mais justamente quando menos vemos a lavoura. Tanto essa contagem quanto a figura 1 usam apenas o período anterior ao teste.
Série decendial e divisão em treino, validação e teste
Para organizar a série em intervalos regulares, agrupamos as observações em decêndios (dekads): dias 1 a 10, 11 a 20 e 21 ao fim do mês. Em cada intervalo, ficamos com o maior NDVI entre as observações aceitas pela máscara de qualidade. Essa operação é a composição pelo valor máximo (maximum value composite). São 36 decêndios por ano, e o decêndio sem nenhuma cena válida fica vazio.
def dekad(ts):
    return pd.Timestamp(ts.year, ts.month, 1 if ts.day <= 10 else 11 if ts.day <= 20 else 21)


grid = pd.DatetimeIndex([pd.Timestamp(y, m, d) for y in range(2019, 2026)
                         for m in range(1, 13) for d in (1, 11, 21)])
ndvi = clean.groupby(clean.index.map(dekad)).max().reindex(grid)   # máximo limpo do decêndio
TRAIN_END = ndvi.index.get_loc(pd.Timestamp("2023-01-01"))    # treino: 2019 a 2022
VAL_END = ndvi.index.get_loc(pd.Timestamp("2025-01-01"))      # validação: 2023 e 2024 | teste selado: 2025
dev = ndvi.iloc[:VAL_END].copy()                            # única série usada no desenvolvimento
gaps = dev.isna().astype(int)
longest = gaps.groupby((gaps != gaps.shift()).cumsum()).sum().max()
print(f"desenvolvimento: decêndios {len(dev)} | observados {dev.notna().sum()} | maior lacuna {longest}")
desenvolvimento: decêndios 216 | observados 150 | maior lacuna 6
No desenvolvimento, 66 dos 216 decêndios estão vazios, e a maior lacuna dura seis decêndios, cerca de dois meses sem observação válida. Todas as tabelas de entrada, os ajustes e as comparações usados para selecionar o modelo recebem apenas a série até 2024. Isso inclui os protocolos com vazamento que vamos construir de propósito. Assim, podemos demonstrar o uso indevido de informações da validação sem misturá-lo com o teste final.
Para ver o pixel no seu contexto, extraí também uma janela de 32×32 pixels de 10 m (320 m de lado) centrada no ponto e montei o NDVI decendial em cada pixel. O resultado é um cubo de dados, uma sequência de imagens organizada em duas dimensões espaciais e uma temporal. A figura 3 mostra apenas 2019 a 2024: cada camada é um decêndio, e os planos coloridos marcam o fim do treino e da validação. Para facilitar a leitura, desenhei 14 dos 216 decêndios. A linha vermelha atravessa o pixel central, que é a série da figura 1, e é só ele que vamos prever. Nesse mesmo período, as correlações dos 1.024 pixels com o central, calculadas nos pares de observações válidas, têm mediana de 0,97; 61,6% passam de 0,9. Essa concordância descreve a janela escolhida, sem ampliar a amostra usada para avaliar as previsões.
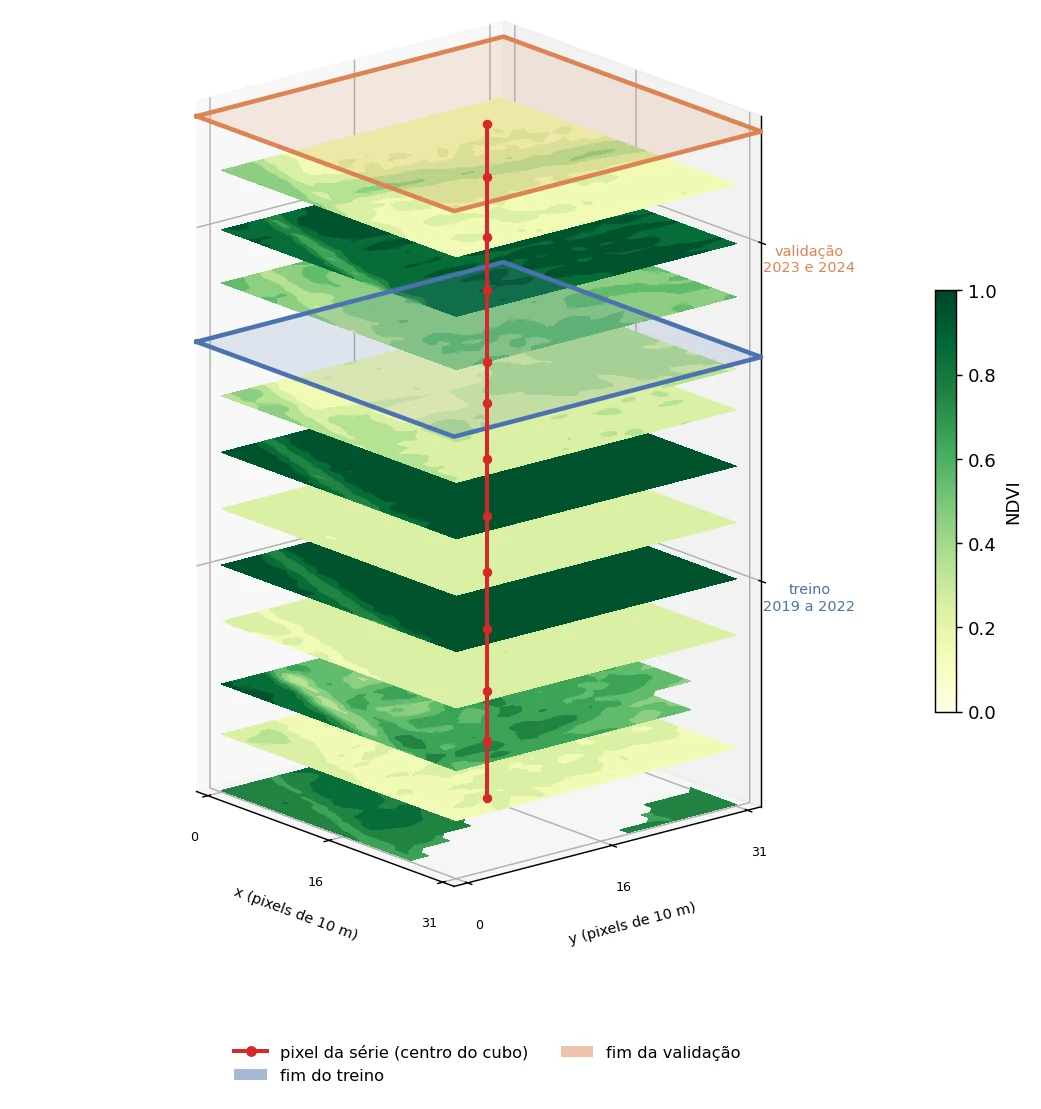
O alvo, isto é, o valor que queremos prever, é o máximo NDVI limpo do próximo decêndio. A previsão é emitida na abertura desse intervalo, supondo que o composto do decêndio anterior já esteja disponível. Chamamos esse momento de origem da previsão. O horizonte é de um passo: estimamos o decêndio seguinte, um intervalo de aproximadamente dez dias. Isso não significa antecedência exata de dez dias para cada imagem. A simulação não inclui atrasos de publicação dos produtos nem a disponibilidade histórica de suas versões reprocessadas.
Chamamos de entradas causais as variáveis construídas somente com informações anteriores à origem da previsão. Neste artigo, o termo "causal" descreve essa disponibilidade temporal. É a regra que permite montar uma entrada como ela estaria disponível no momento de uso do modelo.
Há ainda uma decisão importante: o erro só é medido onde existe observação real. Avaliar contra valores interpolados confundiria a qualidade da previsão com a do preenchimento. Em contrapartida, o erro nos decêndios totalmente encobertos não é diretamente verificável neste experimento. As métricas descrevem o desempenho nos períodos com alvo observado.
MASE com a persistência como referência
Antes de medir qualquer modelo, precisamos de uma referência para interpretar o erro. Usamos uma adaptação do erro absoluto médio escalonado (MASE, de Mean Absolute Scaled Error), proposto por Hyndman e Koehler, 2006. A adaptação considera a observabilidade irregular: a persistência repete a última observação disponível, que pode ser mais antiga que o decêndio anterior.
A definição usada aqui é MASE adaptada = erro absoluto médio nos alvos observados da avaliação / erro absoluto médio da persistência no treino. O erro absoluto médio (MAE, Mean Absolute Error) é a média das distâncias entre os valores previstos e observados, sem considerar o sinal dessas diferenças. O denominador considera apenas os instantes de treino com alvo e previsão de persistência disponíveis e permanece fixo nas comparações. MASE abaixo de 1 significa errar menos do que a persistência errava no treino. Para saber se um modelo supera a persistência na validação ou no teste, comparamos os dois no mesmo período.
LAGS = (1, 2, 3)


def eligible_rows(series, end):
    return [i for i in range(max(LAGS) + 1, end) if pd.notna(series.iloc[i])]


def fill(series):
    """Preenche lacunas: interpola entre observações e repete a última no fim."""
    return series.interpolate(limit_area="inside").ffill()


def persistence(series, start, end):
    """Previsão ingênua: o último NDVI conhecido antes de cada decêndio."""
    return pd.Series([fill(series.iloc[:o]).iloc[-1] for o in range(start, end)],
                     index=series.index[start:end])


SCALE = (dev.iloc[1:TRAIN_END] - persistence(dev, 1, TRAIN_END)).abs().mean()


def mase(y_true, y_pred):
    """MAE só onde há observação real, dividido pelo MAE da persistência no treino."""
    ok = y_true.notna()
    if not y_true.index.equals(y_pred.index) or not np.isfinite(y_pred[ok]).all():
        raise ValueError("É necessária uma previsão finita e alinhada para cada alvo observado.")
    return np.mean(np.abs(y_true[ok] - y_pred[ok])) / SCALE


val = dev.iloc[TRAIN_END:VAL_END]
pers_val = persistence(dev, TRAIN_END, VAL_END)
last_year = pd.Series([fill(dev.iloc[:o]).iloc[o - 36] for o in range(TRAIN_END, VAL_END)], index=val.index)
print(f"escala: {SCALE:.3f} de NDVI | decêndios avaliados na validação: {val.notna().sum()}")
print(f"persistência: MASE = {mase(val, pers_val):.3f}")
print(f"mesmo decêndio do ano anterior: MASE = {mase(val, last_year):.3f}")
escala: 0.101 de NDVI | decêndios avaliados na validação: 46
persistência: MASE = 0.952
mesmo decêndio do ano anterior: MASE = 1.738
A persistência erra, em média, 0,101 de NDVI por decêndio no treino, e na validação fica em 0,952. Já repetir o mesmo decêndio do ano anterior é bem pior, 1,738. Faz sentido: a data de plantio varia algumas semanas de um ano para outro e a segunda safra nem sempre existe, então "o ano passado" erra justamente nas subidas e descidas da curva. A persistência fica, então, como a referência que qualquer modelo precisa superar para justificar a complexidade a mais.
Validação cruzada com cinco grupos aleatórios
Agora montamos a tabela de aprendizado supervisionado: cada exemplo associa variáveis de entrada a um alvo conhecido. Cada linha corresponde a um decêndio t. As variáveis de entrada (features) são o NDVI dos três decêndios anteriores, com as lacunas preenchidas, e a posição do decêndio no ano. Esses valores anteriores são as defasagens (lags) de um, dois e três passos. O alvo é o NDVI observado no decêndio t.
def make_features(series):
    """Linha do decêndio t: NDVI preenchido nos 3 decêndios anteriores e o decêndio do ano."""
    f = fill(series)
    X = pd.DataFrame({f"lag_{k}": f.shift(k) for k in LAGS})
    X["dekad_of_year"] = (series.index.month - 1) * 3 + (series.index.day - 1) // 10
    return X


def new_model(seed=42):
    return RandomForestRegressor(n_estimators=300, min_samples_leaf=3, random_state=seed, n_jobs=-1)
Começamos pelo protocolo deliberadamente incorreto: preenchemos todo o período de desenvolvimento, montamos a tabela e aplicamos o KFold, a implementação da validação cruzada em k grupos. Usamos cinco grupos, também chamados de dobras (folds): em cada rodada, quatro treinam o modelo e o grupo restante serve para avaliá-lo. As linhas são embaralhadas sem respeitar a ordem do tempo. Assim, uma previsão pode ser avaliada por um modelo treinado com observações posteriores. Para comparar os protocolos, medimos o erro nos mesmos 46 decêndios observados da validação e guardamos as dobras para reutilizá-las na condição com entradas causais.
X_all = make_features(dev)                             # interpolação global só até 2024
dev_rows = eligible_rows(dev, VAL_END)
X_dev, y_dev = X_all.iloc[dev_rows], dev.iloc[dev_rows]
folds = list(KFold(n_splits=5, shuffle=True, random_state=42).split(X_dev))
pred_kf = pd.Series(index=y_dev.index, dtype=float)
for tr, te in folds:
    pred_kf.iloc[te] = new_model().fit(X_dev.iloc[tr], y_dev.iloc[tr]).predict(X_dev.iloc[te])
pred_kf = pred_kf.reindex(val.index)
print(f"KFold aleatório: MASE = {mase(val, pred_kf):.3f}")
KFold aleatório: MASE = 0.578
Comparando 0,578 com os 0,952 da persistência na mesma validação, o Random Forest parece errar 39,3% menos. Seria um ótimo resultado para uma série com tanta nuvem. Mas essa avaliação mistura dois problemas: as dobras incluem treinamento com observações posteriores e os lags vêm da interpolação de todo o desenvolvimento. Mais adiante comparamos as combinações para entender como cada escolha se relaciona com o resultado.
Interpolação das lacunas antes do corte
Trocar o sorteio pela ordem do tempo parece suficiente: treinamos em 2019 a 2022 e prevemos 2023 e 2024 em ordem. Mas, se as lacunas foram preenchidas na série inteira antes do corte, o vazamento continua lá, só que escondido.
train_rows = eligible_rows(dev, TRAIN_END)
model = new_model().fit(X_all.iloc[train_rows], dev.iloc[train_rows])
pred_pre = pd.Series(model.predict(X_all.iloc[TRAIN_END:VAL_END]), index=val.index)
print(f"walk-forward, lacunas preenchidas antes: MASE = {mase(val, pred_pre):.3f}")
walk-forward, lacunas preenchidas antes: MASE = 0.887
O modelo ainda parece 6,8% melhor que a persistência, e a figura 4 mostra de onde vem esse ganho. Em 11/02/2024 queremos prever um NDVI que, sabemos depois, foi 0,602. Os dois decêndios anteriores estavam cobertos de nuvem. A interpolação feita com a série inteira os preenche com 0,829 e 0,715, uma linha que já desce em direção ao alvo, porque ela foi traçada usando o próprio alvo. Quem estivesse no campo em 11/02 só saberia que a última imagem limpa, do decêndio de 11/01, marcava 0,942.
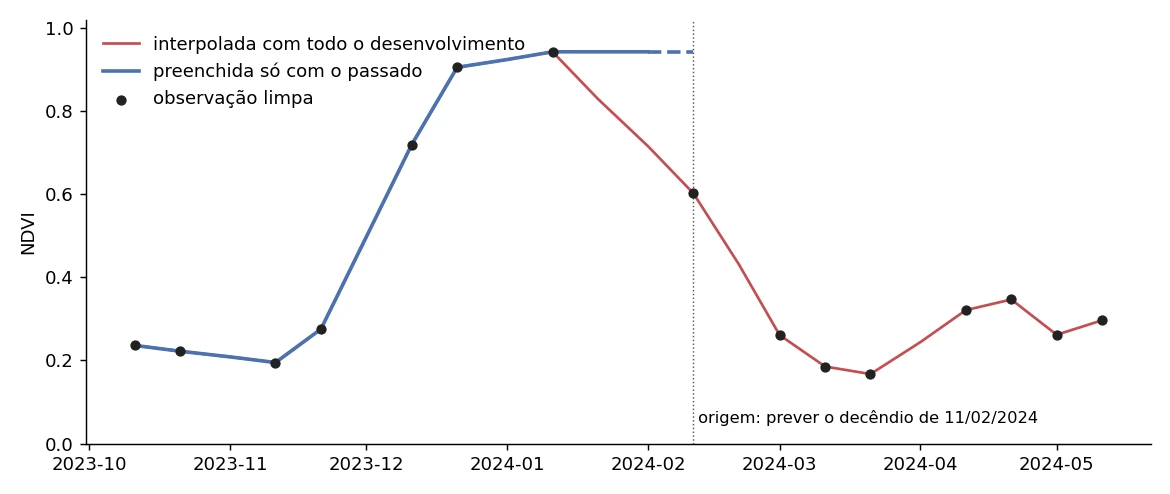
Na interpolação linear, os valores ausentes são preenchidos por uma linha entre duas observações conhecidas. Se a observação da direita ainda não estaria disponível na origem da previsão, ela transfere informação do futuro para a entrada. O mesmo cuidado vale para suavizações, como os filtros de Savitzky-Golay e de Whittaker, quando aplicadas usando observações dos dois lados do tempo. Em séries de imagens de satélite, esse pré-processamento pode ficar num programa separado, executado antes da modelagem, o que torna o vazamento mais difícil de perceber.
Avaliação sequencial com treino e previsão usando só o passado
A avaliação sequencial (walk-forward, em tradução livre, "avançar no tempo") percorre os decêndios em ordem e simula uma previsão a cada origem. Aqui, o modelo é ajustado uma vez antes da validação. Seus parâmetros ficam fixos, enquanto as entradas incorporam as novas observações já disponíveis. Em cada origem o, a linha de variáveis de entrada é recalculada só com a série até o - 1, com o valor de o em branco.
def row_for_day(series, o, features=make_features):
    """A linha do decêndio o montada só com o passado: o valor de o fica vazio."""
    past = series.iloc[:o]
    blank = pd.Series([np.nan], index=series.index[o:o + 1])
    return features(pd.concat([past, blank])).iloc[[-1]]


def walk_forward(series, start, end, features=make_features, past_only_train=True):
    """Ajusta uma vez antes de start e prevê cada decêndio de [start, end) só com o passado."""
    rows = eligible_rows(series, start)
    if past_only_train:    # cada linha de treino montada como seria no dia dela
        X_tr = pd.concat([row_for_day(series, i, features) for i in rows])
    else:                  # linhas de treino da série de treino preenchida de uma vez
        X_tr = features(series.iloc[:start]).iloc[rows]
    model = new_model().fit(X_tr, series.iloc[rows])
    preds = [model.predict(row_for_day(series, o, features))[0] for o in range(start, end)]
    return pd.Series(preds, index=series.index[start:end])


pred_mix = walk_forward(dev, TRAIN_END, VAL_END, past_only_train=False)
pred_wf = walk_forward(dev, TRAIN_END, VAL_END)
print(f"walk-forward, só a previsão com o passado: MASE = {mase(val, pred_mix):.3f}")
print(f"walk-forward, treino e previsão com o passado: MASE = {mase(val, pred_wf):.3f}")
walk-forward, só a previsão com o passado: MASE = 1.243
walk-forward, treino e previsão com o passado: MASE = 1.148
O parâmetro past_only_train, que indica "usar apenas o passado no treino", permite comparar duas formas de construir as entradas de treinamento. Quando ele é falso, só as entradas da previsão respeitam cada origem; as linhas de treino vêm da série de treinamento preenchida de uma vez. Nesse caso, as defasagens do treino podem incorporar informações posteriores ao instante que representam, enquanto as entradas de uso dependem apenas do passado. Essa incompatibilidade entre treinamento e uso (training-serving skew) resulta em MASE de 1,243. Montar também as linhas de treino como estariam disponíveis no dia de cada previsão leva a MASE para 1,148. As duas condições fazem parte da comparação entre protocolos.
A função row_for_day monta a linha de entrada de uma origem usando apenas o passado. Com ela, repetimos o mesmo KFold aleatório, mantendo as dobras e trocando a forma de construir cada linha:
X_dev_p = pd.concat([row_for_day(dev, i) for i in dev_rows])   # mesmas linhas, entradas causais
y_dev_p = y_dev
pred_kf_p = pd.Series(index=y_dev_p.index, dtype=float)
for tr, te in folds:                                       # mesmas dobras da versão interpolada
    pred_kf_p.iloc[te] = new_model().fit(X_dev_p.iloc[tr], y_dev_p.iloc[tr]).predict(X_dev_p.iloc[te])
pred_kf_p = pred_kf_p.reindex(val.index)
print(f"KFold aleatório, linhas só com o passado: MASE = {mase(val, pred_kf_p):.3f}")
KFold aleatório, linhas só com o passado: MASE = 1.118
As quatro combinações ajudam a ler o resultado:
| Divisão dos dados | Interpolação de todo o desenvolvimento | Entradas causais por origem |
|---|---|---|
| KFold aleatório | 0,578 | 1,118 |
| Cronológica, modelo fixo | 0,887 | 1,148 |
Com entradas causais, o KFold fica perto da avaliação cronológica neste pixel. Já a interpolação global está associada às maiores reduções de erro aparente, sobretudo quando combinada ao sorteio das dobras. As comparações apontam essa interpolação como a principal fonte do otimismo observado, mas não permitem atribuir uma parcela exata do efeito a cada mudança: os protocolos também diferem na composição e no período de treinamento. O resultado vale para este pixel e estas variáveis de entrada. O KFold aleatório continua inadequado para simular a previsão futura porque inclui treino com observações posteriores ao alvo avaliado.
Voltando à avaliação sequencial: 1,148 ainda é 20,6% pior que a persistência. Nas lacunas longas, o modelo não sabe que está olhando para uma imagem velha. Então damos a ele essa informação, honesta e disponível no dia: há quantos decêndios saiu a última observação limpa. Essa é a idade da observação, medida em decêndios.
def make_features_age(series):
    """As mesmas features e há quantos decêndios saiu a última observação limpa."""
    X = make_features(series)
    pos = np.arange(len(series))
    last_seen = pd.Series(np.where(series.notna(), pos, np.nan), index=series.index).ffill()
    X["obs_age"] = pos - last_seen.shift(1).to_numpy()
    return X


pred_age = walk_forward(dev, TRAIN_END, VAL_END, features=make_features_age)
print(f"walk-forward com idade da observação: MASE = {mase(val, pred_age):.3f}")
walk-forward com idade da observação: MASE = 1.070
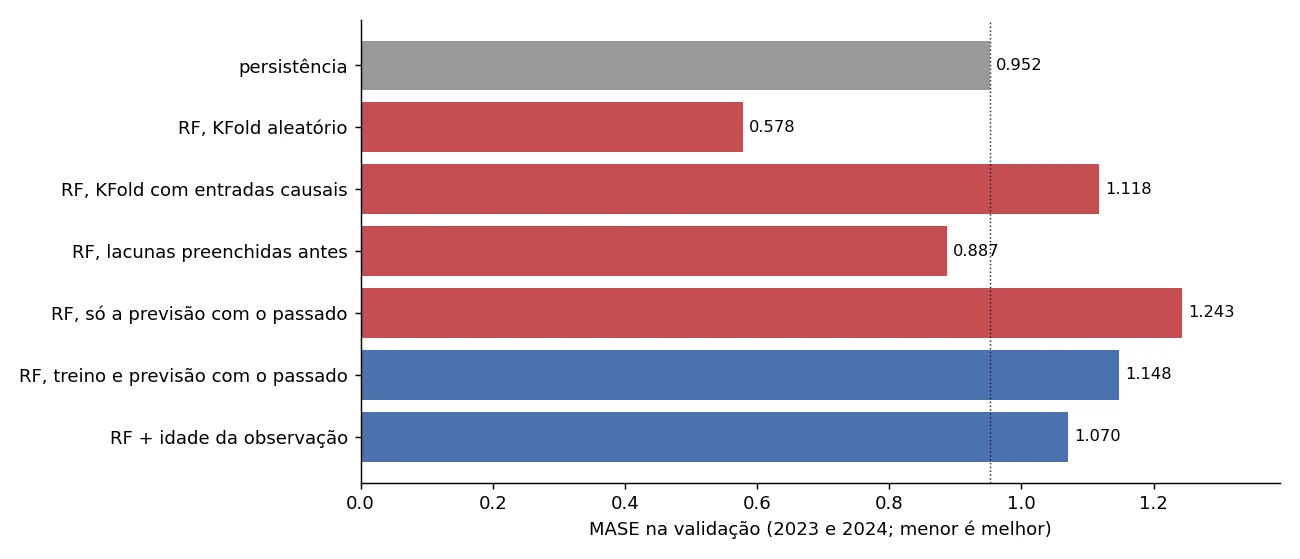
A figura 5 resume a validação. As barras vermelhas representam problemas diferentes: treinamento com observações posteriores no KFold, interpolação que usa observações anteriores e posteriores nas entradas ou construção do treino com informações que não estariam disponíveis em cada origem. Isso não produz ganho aparente em todas as configurações. O KFold com interpolação global e o preenchimento prévio ficam abaixo da persistência; o KFold com entradas causais e a condição causal apenas na previsão ficam acima. Nos dois primeiros casos, a comparação dos erros médios sugere uma troca de modelo que a avaliação causal não sustenta. A análise de incerteza mostra quanto podemos concluir dessas diferenças.
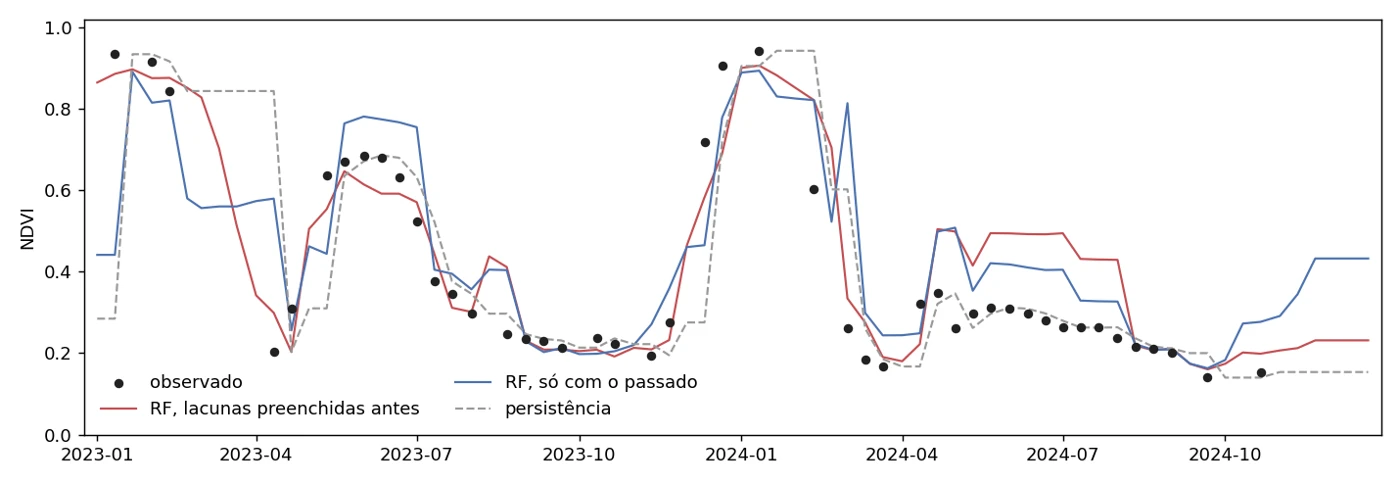
Na figura 6 dá para ver onde o modelo honesto perde: depois da colheita de 2023 e em março de 2024, ele demora a acompanhar a queda do NDVI, preso a valores altos de imagens antigas, porque a lacuna esconde a colheita. O modelo com lacunas preenchidas antes parece mais esperto justamente nesses trechos, porque a interpolação já lhe entregou a direção da curva.
Erro por fase da cultura: safra e resto do ano
A média esconde uma divisão importante. Dos 46 decêndios observados na validação, só 12 caem na safra de soja, de outubro a fevereiro; os outros 34 estão no resto do ano, quando o NDVI muda devagar. Separando o erro pelas duas fases:
safra = val.index.month.isin([10, 11, 12, 1, 2])
print(f"decêndios observados: safra {val[safra].notna().sum()} | resto do ano {val[~safra].notna().sum()}")
for name, p in [("persistência", pers_val), ("lacunas preenchidas antes", pred_pre),
                ("treino e previsão com o passado", pred_wf), ("RF + idade da observação", pred_age)]:
    print(f"{name}: safra {mase(val[safra], p[safra]):.3f} | resto do ano {mase(val[~safra], p[~safra]):.3f}")
decêndios observados: safra 12 | resto do ano 34
persistência: safra 1.572 | resto do ano 0.733
lacunas preenchidas antes: safra 0.735 | resto do ano 0.940
treino e previsão com o passado: safra 1.323 | resto do ano 1.086
RF + idade da observação: safra 1.243 | resto do ano 1.009
Todos os modelos honestos erram mais na safra, quando a lavoura muda rápido e as nuvens escondem a mudança. Só que, nessa fase, o Random Forest honesto vence a persistência (1,243 contra 1,572, com a idade da observação). Ele perde no resto do ano, quando repetir a última imagem é quase imbatível (0,733), e como esse período tem quase três vezes mais pontos, é ele que decide a média. Já o modelo com lacunas preenchidas antes chega a 0,735 justamente na safra, onde as lacunas são mais longas, o que é compatível com a interpolação entregando mais do futuro exatamente ali.
Quanto dessas diferenças é ruído
Até aqui, os resultados usam a semente 42 e 46 alvos observados. A semente aleatória é o número que inicializa as operações de sorteio e permite repetir uma execução nas mesmas condições. Para examinar a variação, repeti as avaliações com as sementes de 0 a 9. No Random Forest, muda a aleatoriedade do modelo; no KFold, mudam também as dobras. Dentro de cada semente, as condições com interpolação global e com entradas causais usam exatamente as mesmas linhas e dobras. Portanto, essa tabela mede a sensibilidade conjunta ao modelo e, nos protocolos com KFold, à divisão dos dados. A semente 42 não faz parte dessas dez repetições.
| Avaliação na validação | mínimo | mediana | máximo |
|---|---|---|---|
| KFold aleatório | 0,521 | 0,556 | 0,587 |
| lacunas preenchidas antes | 0,824 | 0,848 | 0,876 |
| KFold aleatório, linhas só com o passado | 0,984 | 1,077 | 1,111 |
| só a previsão com o passado | 1,179 | 1,207 | 1,231 |
| treino e previsão com o passado | 1,123 | 1,144 | 1,160 |
| RF + idade da observação | 1,046 | 1,067 | 1,092 |
Nas dez sementes, o KFold com interpolação global e o protocolo cronológico com preenchimento prévio ficam abaixo dos 0,952 da persistência. As configurações com treino e previsão causais ficam acima. Os outros dois protocolos com problemas metodológicos também ficam acima da referência, mostrando que o vazamento ou a incompatibilidade entre treino e uso não garantem uma redução do erro aparente.
A semente, porém, não é a única fonte de variação. Para examinar a incerteza associada ao período observado, usei reamostragem por blocos (block bootstrap). O procedimento monta novas amostras sorteando trechos da grade temporal completa. O sorteio é feito com reposição, ou seja, um mesmo trecho pode aparecer mais de uma vez na amostra. Em cada repetição, recalculamos a diferença de MASE entre o modelo e a persistência. Só depois de montar a amostra selecionamos os alvos observados. Assim, os blocos mantêm a ordem local e as lacunas dentro de cada trecho, sem tratar os 46 alvos como se fossem necessariamente consecutivos. O cálculo mantém as previsões e a escala do treino fixas, sem reajustar os modelos em cada reamostragem.
Começamos com blocos de seis decêndios, cerca de dois meses, e 5.000 reamostragens. Nas saídas, IC95% identifica o intervalo de confiança de 95%, calculado aqui entre os percentis 2,5 e 97,5 das diferenças reamostradas. Esses percentis são os limites que deixam 2,5% das diferenças em cada extremidade da distribuição. A última coluna informa a proporção de reamostragens com diferença negativa, favorável ao modelo. Ela não é uma probabilidade calibrada de que o modelo seja superior.
def block_bootstrap_diff(y_true, pred, ref, block=6, n=5000, seed=0):
    """IC percentil e proporção de reamostragens com diferença de MASE negativa."""
    if not 1 <= block <= len(y_true) or n < 1:
        raise ValueError("Bloco e número de reamostragens inválidos.")
    mase(y_true, pred)  # confere alinhamento e previsões nos alvos observados
    mase(y_true, ref)
    rng = np.random.default_rng(seed)
    ok = y_true.notna().to_numpy()
    e_m = np.abs(y_true - pred).to_numpy() / SCALE
    e_r = np.abs(y_true - ref).to_numpy() / SCALE
    T = len(y_true)
    starts = np.arange(T - block + 1)
    diffs = []
    for _ in range(n):
        idx = np.concatenate([np.arange(s, s + block) for s in rng.choice(starts, size=int(np.ceil(T / block)))])[:T]
        sel = idx[ok[idx]]
        if len(sel) == 0:
            continue
        diffs.append(e_m[sel].mean() - e_r[sel].mean())
    if not diffs:
        raise ValueError("Nenhuma reamostragem continha um alvo observado.")
    diffs = np.array(diffs)
    point = e_m[ok].mean() - e_r[ok].mean()
    return point, np.percentile(diffs, 2.5), np.percentile(diffs, 97.5), (diffs < 0).mean()


for name, p in [("KFold aleatório", pred_kf), ("KFold só com o passado", pred_kf_p),
                ("lacunas preenchidas antes", pred_pre), ("treino e previsão com o passado", pred_wf),
                ("RF + idade", pred_age)]:
    d, lo, hi, p_neg = block_bootstrap_diff(val, p, pers_val)
    print(f"{name}: {d:+.3f}  IC95% [{lo:+.3f}; {hi:+.3f}]  proporção negativa = {p_neg:.2f}")
KFold aleatório: -0.374  IC95% [-0.717; -0.017]  proporção negativa = 0.98
KFold só com o passado: +0.166  IC95% [-0.108; +0.440]  proporção negativa = 0.12
lacunas preenchidas antes: -0.065  IC95% [-0.631; +0.600]  proporção negativa = 0.49
treino e previsão com o passado: +0.196  IC95% [-0.129; +0.492]  proporção negativa = 0.11
RF + idade: +0.118  IC95% [-0.214; +0.433]  proporção negativa = 0.20
Com blocos de seis decêndios, só o KFold com interpolação global apresenta intervalo inteiramente abaixo de zero. Nas duas avaliações com treino e previsão causais, os intervalos incluem zero, e o Random Forest fica à frente da persistência em cerca de 11% a 20% das reamostragens. Isso não demonstra que os modelos sejam equivalentes nem que o Random Forest seja necessariamente pior; esta validação não apresenta evidência clara de ganho.
Para conferir quanto a leitura depende do tamanho dos blocos, repeti o cálculo com três e doze decêndios. A tabela mostra os intervalos percentis de 95% da diferença de MASE, sempre modelo menos persistência:
| Avaliação | Blocos de 3 | Blocos de 6 | Blocos de 12 |
|---|---|---|---|
| KFold com interpolação global | [-0,727; -0,030] | [-0,717; -0,017] | [-0,711; +0,001] |
| KFold com entradas causais | [-0,074; +0,415] | [-0,108; +0,440] | [-0,123; +0,461] |
| Lacunas preenchidas antes | [-0,576; +0,482] | [-0,631; +0,600] | [-0,689; +0,708] |
| Treino e previsão com o passado | [-0,103; +0,479] | [-0,129; +0,492] | [-0,143; +0,532] |
| RF + idade da observação | [-0,197; +0,415] | [-0,214; +0,433] | [-0,259; +0,473] |
A ausência de ganho claro nas avaliações causais se mantém nas três escolhas. Já o intervalo do KFold com interpolação global passa a incluir zero com blocos de doze decêndios. Sua vantagem na estimativa calculada sobre os dados observados, a estimativa pontual, permanece, mas a afirmação sobre o intervalo depende da escolha do bloco. Dois anos de validação também limitam o exame de dependências sazonais mais longas. Os resultados completos estão na tabela de reamostragem por blocos e no registro de reprodução da execução, que informa as versões das bibliotecas, as configurações e as identificações dos arquivos usados.
Ah João, então o Random Forest não serve para isso?
Não é isso que o experimento diz. Ele diz que, com estas entradas, num único pixel e com 46 alvos observados na validação, não demonstramos um ganho que justifique substituir a persistência. Outros pixels e outras variáveis podem mudar o resultado, mas exigem novos experimentos. Sem a avaliação causal, a redução aparente de 39,3% no erro poderia sustentar uma escolha que os resultados disponíveis não justificam.
Avaliação final no teste de 2025
A regra de decisão é simples: o modelo mais complexo só substitui a persistência se apresentar menor erro médio na validação; a análise de incerteza ajuda a qualificar essa comparação. O Random Forest com entradas causais não supera a referência na média em nenhuma das dez sementes, então a escolha é a persistência. Essa seleção ocorre antes de calcular os resultados de 2025.
O teste é chamado de "selado" porque fica fora das etapas de construção das entradas, ajuste e comparação usadas para selecionar o modelo. As figuras e as estatísticas exploratórias usam apenas dados até 2024. Depois da seleção, calculamos o desempenho em 2025; as comparações adicionais nesse período têm caráter descritivo e não redefinem a escolha. A avaliação é uma simulação sobre dados históricos, com as hipóteses de disponibilidade das observações descritas no protocolo.
sealed = ndvi.iloc[VAL_END:]
pers_test = persistence(ndvi, VAL_END, len(ndvi))
print(f"decêndios avaliados no teste: {sealed.notna().sum()}")
print(f"teste selado, persistência: MASE = {mase(sealed, pers_test):.3f}")
decêndios avaliados no teste: 27
teste selado, persistência: MASE = 0.910
A persistência fica em 0,910 em 2025, próxima dos 0,952 da validação. Esse é o número que vai para o relatório.
Como comparação descritiva, avaliamos também o Random Forest com a idade da observação. Nesse passo, ele é ajustado com os dados de 2019 a 2024, mantendo as mesmas entradas causais e configurações. Durante 2025, seus parâmetros ficam fixos e as entradas recebem apenas observações anteriores a cada previsão. A escala da MASE continua sendo a calculada no período de treino, de 2019 a 2022.
pred_test_age = walk_forward(ndvi, VAL_END, len(ndvi), features=make_features_age)
print(f"teste selado, RF + idade da observação: MASE = {mase(sealed, pred_test_age):.3f}")
teste selado, RF + idade da observação: MASE = 0.874
Em 2025, o Random Forest foi 4,0% melhor que a persistência, o contrário do que a validação mostrou. Passando o teste pelo mesmo bootstrap:
d, lo, hi, p_neg = block_bootstrap_diff(sealed, pred_test_age, pers_test)
print(f"RF + idade (teste): {d:+.3f}  IC95% [{lo:+.3f}; {hi:+.3f}]  proporção negativa = {p_neg:.2f}")
RF + idade (teste): -0.036 IC95% [-0.262; +0.219] proporção negativa = 0.50
Ah João, então eu troco para o Random Forest?
Não com base nessa comparação. Trocar agora usaria o resultado de 2025 para selecionar o modelo. Com blocos de seis decêndios, o intervalo da diferença vai de -0,262 a +0,219 e inclui zero. Isso também ocorre com blocos de três, cujo intervalo é [-0,333; +0,304], e de doze, [-0,156; +0,139]. Nas dez sementes, a estimativa pontual do Random Forest fica abaixo de 0,910, mas essa estabilidade não elimina a incerteza de avaliar apenas 27 alvos observados em um ano. Os resultados disponíveis não demonstram um ganho claro. Uma nova decisão exige congelar o protocolo e avaliar um bloco futuro ainda não consultado.
Conclusão
Começamos com um Random Forest que, pelo KFold com interpolação global, parecia errar 39,3% menos que a persistência. Na comparação entre protocolos, a interpolação está associada à maior parte do otimismo observado neste pixel. Respeitando a ordem do tempo, mas mantendo o preenchimento prévio, a vantagem aparente ainda era de 6,8%. Com treino e previsão causais, o erro médio ficou 20,6% acima da persistência, ou 12,4% com a idade da observação. A escolha pela persistência se manteve nas dez sementes. O bootstrap com blocos de três, seis e doze decêndios não apresentou evidência clara de ganho nas avaliações causais. Em 2025, a persistência ficou em 0,910, próxima dos 0,952 da validação; a pequena vantagem pontual do Random Forest nesse ano também veio acompanhada de intervalos que incluem zero.
O protocolo começa pelo corte cronológico e pela definição do que está disponível em cada origem. As entradas de treino e previsão precisam respeitar essa disponibilidade, e os modelos devem ser comparados com uma referência simples no mesmo conjunto de alvos. Etapas que aprendem parâmetros de pré-processamento também devem respeitar os dados de treinamento permitidos pelo protocolo. Ao acompanhar previsões futuras em uma avaliação prospectiva, o teste deve permanecer fora das decisões, com as escolhas registradas antes da abertura. Essa disciplina mantém a avaliação alinhada à forma como o modelo será usado.
Este é um estudo demonstrativo de um pixel, com 46 alvos observados na validação e 27 no teste. Os números mostram como a avaliação muda neste caso; não estimam a magnitude típica do vazamento em outras regiões, culturas ou condições de nuvem. Também não estabelecem o erro nos períodos sem observação válida. Essas extensões dependem de experimentos independentes.
Em séries de imagens de satélite, esse cuidado pesa ainda mais, porque a nuvem não é só ruído: ela decide o que o modelo pode saber em cada decêndio. Neste pixel, foi na safra, a fase com mais nuvem, que a interpolação mais favoreceu o modelo com vazamento e que todos os modelos honestos mais erraram. Validar sem vazamento é medir o modelo pelo que ele faz com o céu que realmente teve, e não com a curva limpa que desenhamos depois.
Referência
HYNDMAN, Rob J.; KOEHLER, Anne B. Another look at measures of forecast accuracy. International Journal of Forecasting, v. 22, n. 4, p. 679-688, 2006. DOI: 10.1016/j.ijforecast.2006.03.001