Predição de evasão de clientes em empresas de telecomunicações

Empresas prestadoras de serviços de comunicações costumam usar análises das insatisfações de clientes, identificando sempre se seus clientes estão confirmados ou não, essas análises são umas das principais métricas para manter e adquirir novos compradores. Em geral, as empresas desses setores costumam ter agências de atendimento ao cliente, onde uma das suas principais tarefas é tentar reconquistar aqueles clientes perdidos, os quais podem custar muito mais do que os novos.
Devido a isso, as empresas investem em novas tecnologias para realizar essas análises, estas comummente utilizam-se do Churn rate, ou simplesmente Churn, uma das formas de medir essa taxa de evasão dos clientes. Além de identificar essa taxa de evasão, o Churn auxilia a identificar futuros cancelamentos, realizando uma predição que auxilia na tomada de decisão e promoção de ações diferenciadas para estes clientes. Uma aplicação cotidiana nossa, são nas empresas de streaming como Spotify e Netflix.
Por ser uma métrica tão importante, o Carlos Melos no seu curso Data Science, na prática nos passou um desafio, implementar do zero uma solução de Churn para uma empresa de telecomunicação, utilizando-se de dados reais. Os dados utilizados neste projeto foram originalmente disponibilizados na plataforma de ensino da IBM Developer, tais dados tratam-se de um típico problema das companhias de telecomunicações, no qual pode ser visto o dataset completo neste link.
Os dados disponibilizados pela IBM não apresentam informações explícitas, mas por vantagem, os nomes das colunas permitem facilmente o entendimento do problema, como podemos constatar nas cinco primeiras entradas abaixo, a qual introduz um dataset de 7043 entradas com 21 colunas.
| customerID | gender | SeniorCitizen | Partner | Dependents | tenure | PhoneService | MultipleLines | InternetService | OnlineSecurity | OnlineBackup | DeviceProtection | TechSupport | StreamingTV | StreamingMovies | Contract | PaperlessBilling | PaymentMethod | MonthlyCharges | TotalCharges | Churn | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 7590-VHVEG | Female | 0 | Yes | No | 1 | No | No phone service | DSL | No | Yes | No | No | No | No | Month-to-month | Yes | Electronic check | 29.85 | 29.85 | No |
| 1 | 5575-GNVDE | Male | 0 | No | No | 34 | Yes | No | DSL | Yes | No | Yes | No | No | No | One year | No | Mailed check | 56.95 | 1889.5 | No |
| 2 | 3668-QPYBK | Male | 0 | No | No | 2 | Yes | No | DSL | Yes | Yes | No | No | No | No | Month-to-month | Yes | Mailed check | 53.85 | 108.15 | Yes |
| 3 | 7795-CFOCW | Male | 0 | No | No | 45 | No | No phone service | DSL | Yes | No | Yes | Yes | No | No | One year | No | Bank transfer (automatic) | 42.30 | 1840.75 | No |
| 4 | 9237-HQITU | Female | 0 | No | No | 2 | Yes | No | Fiber optic | No | No | No | No | No | No | Month-to-month | Yes | Electronic check | 70.70 | 151.65 | Yes |
Como passo inicial para qualquer projeto de Data Science , uma boa análise exploratória é de suma importância. Desta maneira, realizei algumas das análises que achei mais importante, iniciando por uma avaliação dos valores únicos.
Nesta avaliação, foi possível notar que as camadas em questão apresentam em sua maioria mais de dois tipos de classificação, sendo necessário realizar alguns procedimentos mais a frente para alimentação do modelo. Outras avaliações foram necessárias, como: identificação de outliers, estatística descritiva dos dados e a presença de Bias (Vieses) .
| SeniorCitizen | tenure | MonthlyCharges | TotalCharges | |
|---|---|---|---|---|
| count | 7043.000000 | 7043.000000 | 7043.000000 | 7043.000000 |
| mean | 0.162147 | 32.371149 | 64.761692 | 2281.916928 |
| std | 0.368612 | 24.559481 | 30.090047 | 2265.270398 |
| min | 0.000000 | 0.000000 | 18.250000 | 18.800000 |
| 25% | 0.000000 | 9.000000 | 35.500000 | 402.225000 |
| 50% | 0.000000 | 29.000000 | 70.350000 | 1397.475000 |
| 75% | 0.000000 | 55.000000 | 89.850000 | 3786.600000 |
| max | 1.000000 | 72.000000 | 118.750000 | 8684.800000 |
Entretanto, a estatística descritiva e avaliação da presença de outliers não disse muita coisa. Assim, fiz uma verificação a camada Tenure, a qual representa o tempo que cada cliente utilizou o serviço, podendo mostrar a "fidelidade de serviço". Assumindo que a unidade de tempos da camada Tenure é em meses.
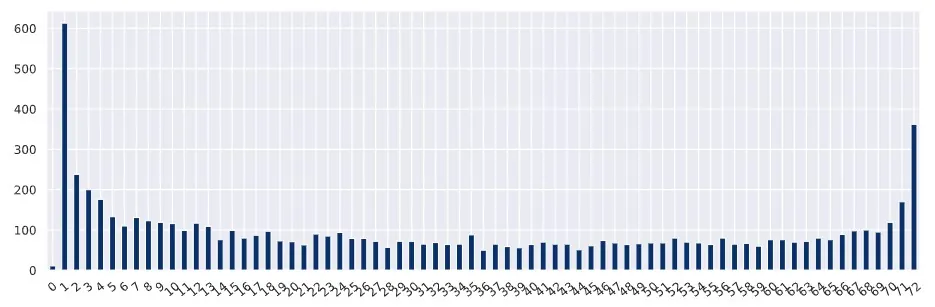
Note que, o tempo de serviço utilizado apresenta uma queda do primeiro mês para os demais, com uma subida nos últimos meses de 70 a 72, mas com uma certa normalidade dos dados. De todos os procedimentos citados anteriormente, darei destaque a presença de Bias, pois as demais não apresentaram resultados que possam comprometer o modelo.
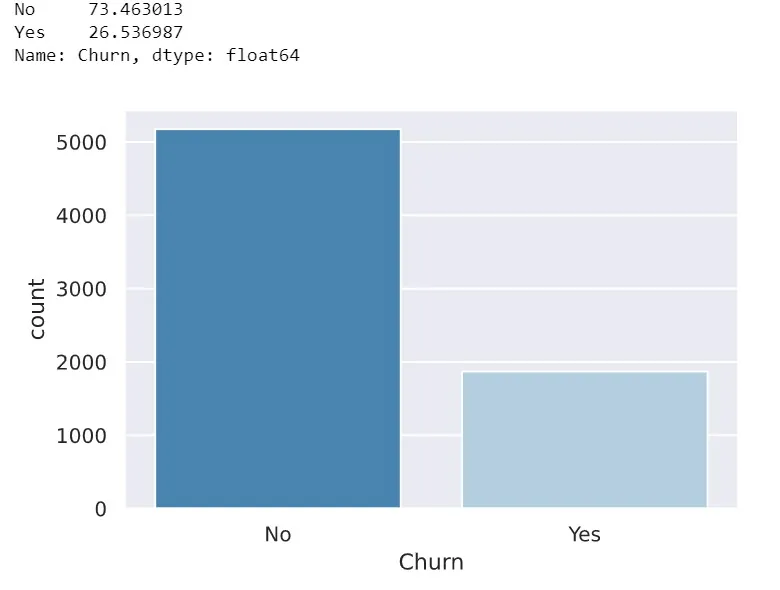
Os vieses analisados foram das camadas: gender (gênero), Partner (parcerias) e Churn (Taxa de evasão), entretanto, somente a última apresentou um desbalanceamento comprometedor, sendo então necessário realizar o balanceamento, como você pode ver abaixo:
Já para as outras camadas, poderia utilizar os seus valores únicos como sendo a mesma coisa, em especial as de serviço. Mesmo esta hipótese ser completamente válida, para o trabalho aqui em questão irei utilizá-los como variáveis únicas.
Nesta etapa realizei algumas manipulações, para preparação dos dados para construção de um bom modelo. Primeiro realizar o pré-processamento, utilizando os algorítimos LabelEcoder e Getdummies, para transformar em variáveis binárias, deixando cada classe em uma camada com um valor numérico e diferente, como pode ver abaixo:
| gender | SeniorCitizen | Partner | Dependents | tenure | PhoneService | PaperlessBilling | MonthlyCharges | TotalCharges | Churn | MultipleLines_No | MultipleLines_No phone service | MultipleLines_Yes | InternetService_DSL | InternetService_Fiber optic | InternetService_No | OnlineSecurity_No | OnlineSecurity_No internet service | OnlineSecurity_Yes | OnlineBackup_No | OnlineBackup_No internet service | OnlineBackup_Yes | DeviceProtection_No | DeviceProtection_No internet service | DeviceProtection_Yes | TechSupport_No | TechSupport_No internet service | TechSupport_Yes | StreamingTV_No | StreamingTV_No internet service | StreamingTV_Yes | StreamingMovies_No | StreamingMovies_No internet service | StreamingMovies_Yes | Contract_Month-to-month | Contract_One year | Contract_Two year | PaymentMethod_Bank transfer (automatic) | PaymentMethod_Credit card (automatic) | PaymentMethod_Electronic check | PaymentMethod_Mailed check | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 29.85 | 29.85 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 0 |
| 1 | 1 | 0 | 0 | 0 | 34 | 1 | 0 | 56.95 | 1889.50 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 |
| 2 | 1 | 0 | 0 | 0 | 2 | 1 | 1 | 53.85 | 108.15 | 1 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 1 |
| 3 | 1 | 0 | 0 | 0 | 45 | 0 | 0 | 42.30 | 1840.75 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 0 | 0 | 0 | 2 | 1 | 1 | 70.70 | 151.65 | 1 | 1 | 0 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 | 0 |
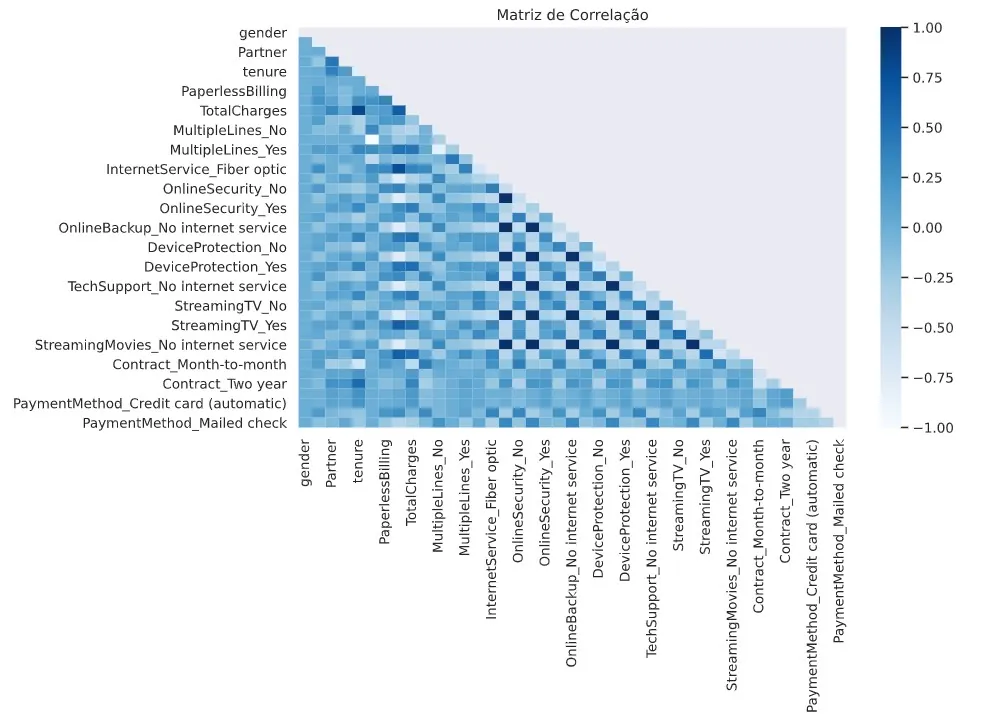
E então, podendo gerar nossa matriz de correlação dos dados.
Com tudo isso realizado, podemos dar início aos preprocessamentos e criando nossa métrica de desempenho. Para tal métrica utiliza como estimador de erro o método Cross-Validation, o qual já falei em outro artigo. Tal método associado a métrica do recall para descobrir qual melhor modelo para esse problema.
Então, para facilitar a avaliação dos modelos, defini uma função de validação:
#Função de validação

def valid(X, y, model, quite = False):

  X = np.array(X)
  y = np.array(y)
  pipeline = make_pipeline(StandardScaler(), model)
  scores = cross_val_score(pipeline, X, y, scoring="recall")

  if quite == False:
     print("Recall: {:.3f} (+/- {:.3f})".format(scores.mean(), scores.std()))

  return scores.mean()
A qual retorna o valor do recall e o score. Construindo então uma baseline de comparação, para parâmetro para avaliar que modelos utilizei.
#Criando linha base
rfc = RandomForestClassifier()
score_baseline = valid(X_treino, y_treino, rfc)
Resultando em Recall: 0.485 (+/- 0.022), essa técnica de validação foi baseada da Under Sampling, e seguindo recomendações de algumas literaturas, os dados serão padronizados antes de usar essa técnica de balanceamento, deixando claro que somente na base de treino.
Como não sei qual modelo apresentará o melhor resultado, realizarei a validação cruzada para os seguintes modelos:
- Floresta aleatória
- Árvores de Decisão
- Gradiente Descendente Estocástico
- SVC
- Regressão Logística
- LightGBM
Foi necessário então instancia-lo e configura-los segundo o algorítimo abaixo:
#Instanciar os modelos
rc = RandomForestClassifier()
ad = DecisionTreeClassifier()
gde = SGDClassifier()
svc = SVC()
rl = LogisticRegression()
xgb = XGBClassifier()
lgbm = LGBMClassifier()
#Criar lista para resultados
modelo = []
recall = []
#Avaliar desempenho
for clf in (rc, ad, gde, svc, rl, xgb, lgbm):
  modelo.append(clf.__class__.__name__)
  recall.append(valid(X_treino_rus, y_treino_rus, clf, quite = True))

Recall = pd.DataFrame(data = recall, index=modelo, columns=["Recall"])
Gerando o seguinte resultado,
| Recall | |
|---|---|
| LogisticRegression | 0.803375 |
| SVC | 0.793548 |
| XGBClassifier | 0.792170 |
| LGBMClassifier | 0.769701 |
| RandomForestClassifier | 0.752854 |
| SGDClassifier | 0.707198 |
| DecisionTreeClassifier | 0.701591 |
Podemos ver nos resultados, ressaltaram-se os resultados dos modelos XGBoost, Regressão Logística e SVC. Em que, tiveram os suas instâncias em default. Com isso, pegarei o melhor modelo anterior (XGBoost) e modificarei seus parâmetros procurando o melhor resultado possível, onde você pode encontra no projeto completo.
Avaliando algumas estruturas do XGboost, encontrei o melhor resultado como:
#Modelo Final
xgb=XGBClassifier(learning_rate=0.001,n_estimators=50,max_depth=1,min_child_weight=1,gamma=0.0)xgb.fit(X_treino_rus,y_treino_rus)
XGBClassifier(base_score=0.5, booster='gbtree', colsample_bylevel=1,
              colsample_bynode=1, colsample_bytree=1, gamma=0.0,
              learning_rate=0.001, max_delta_step=0, max_depth=1,
              min_child_weight=1, missing=None, n_estimators=50, n_jobs=1,
              nthread=None, objective='binary:logistic', random_state=0,
              reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
              silent=None, subsample=1, verbosity=1)
Resultando os seguintes valores de previsão:
              precision    recall  f1-score   support

           0       0.94      0.57      0.71      1316
           1       0.41      0.89      0.56       445

    accuracy                           0.65      1761
   macro avg       0.67      0.73      0.64      1761
weighted avg       0.80      0.65      0.67      1761

Área sobre a curva ASC: 0.7284109149277687
E a Matriz de confusão:
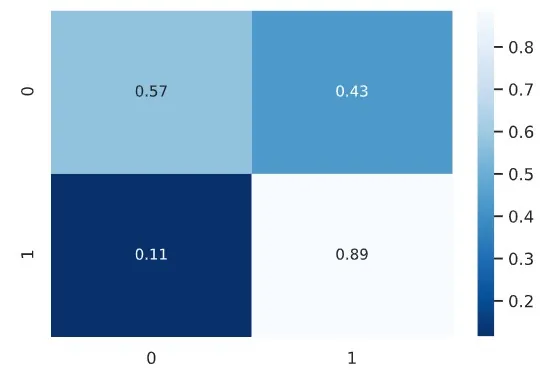
Resultando então em um excelente modelo, com 0.89 dos dados Verdadeiros Positivos e 0.57 verdadeiros negativos, com uma ASC de 0.72.
Neste projeto, trabalhamos em um problema de previsão de churn em que o objetivo principal era construir um modelo de aprendizado de máquina capaz de identificar corretamente os maiores números de possíveis clientes que envasaram. Para tanto, foi necessário realizar diversos procedimentos como balanceamento e padronização, testando diversos modelos para obter o melhor resultado, assim chegando a um modelo de XGboost com um excelente resultado.