

Contador de gado em vídeo de drone: a arquitetura de execução em Docker


Esses dias fui chamado para montar um contador de gado em vídeo de drone, e decidi fazer um tutorial básico de como aproveitar modelos pré-treinados e fazer o deploy no Docker, para poder reutilizar o serviço depois.
Neste artigo mostro o que montei, um serviço de lote que lê uma pasta de vídeos de drone, conta o gado com um detector já treinado e um rastreador, e escreve um JSON por vídeo. Não treinei nada. Nos dois vídeos que testei, ele estima 36 animais num pasto, o que bate com a contagem de referência, e 246 num rebanho em movimento, provavelmente abaixo do real.
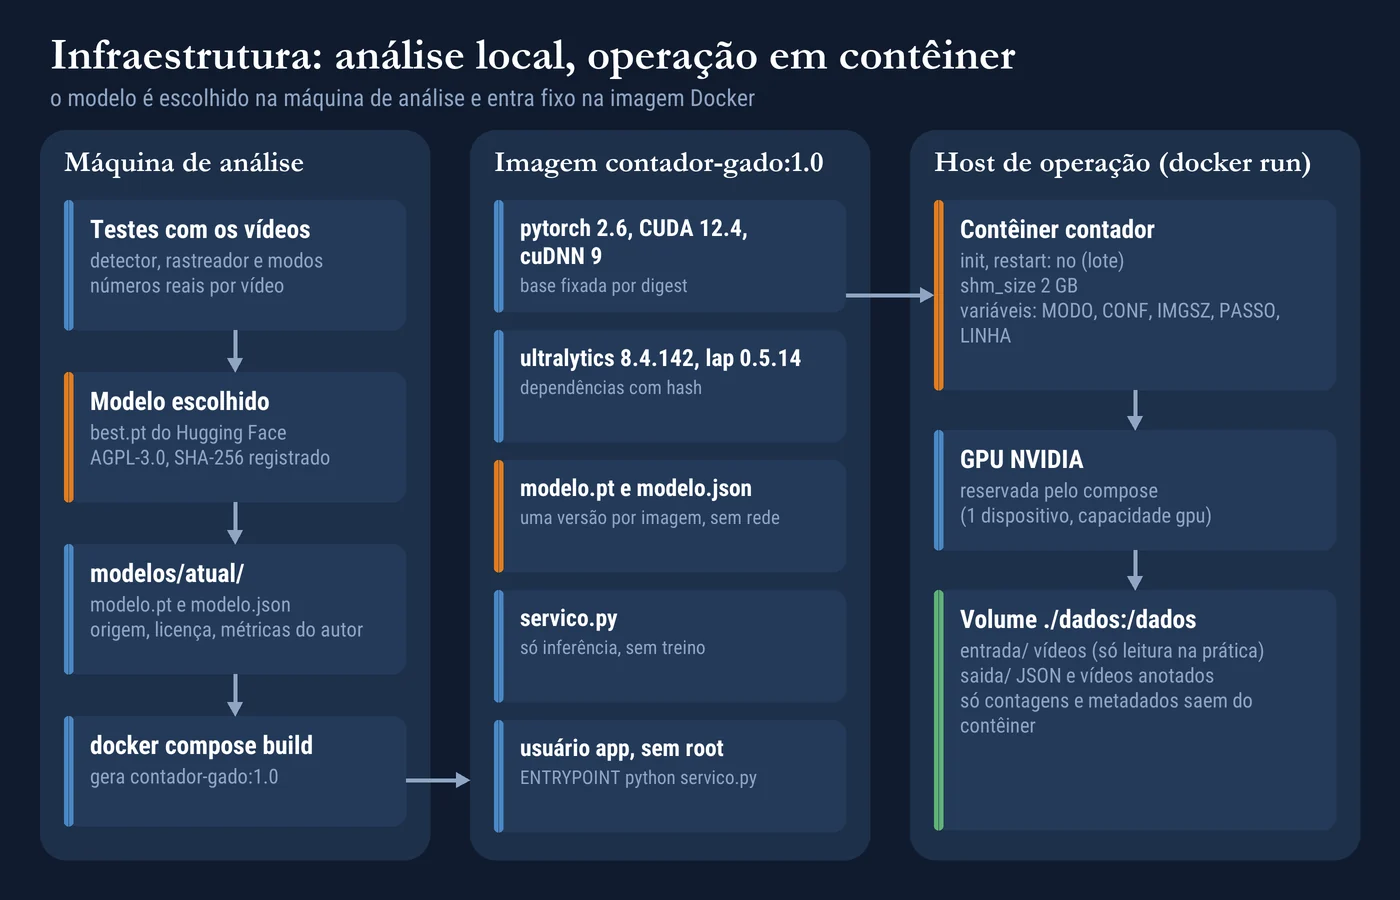
O difícil é o que vem depois que a contagem funciona. Alguém vai deixar uma pasta de vídeos de drone, esperar um número por vídeo e, três meses depois, perguntar de onde veio aquele número e com qual versão do modelo. Por isso o foco aqui é a arquitetura de execução. A análise e a escolha do modelo acontecem na minha máquina, onde testo detectores e modos de contagem nos vídeos, e o que vai para o Docker é só o modelo escolhido e o código de inferência.
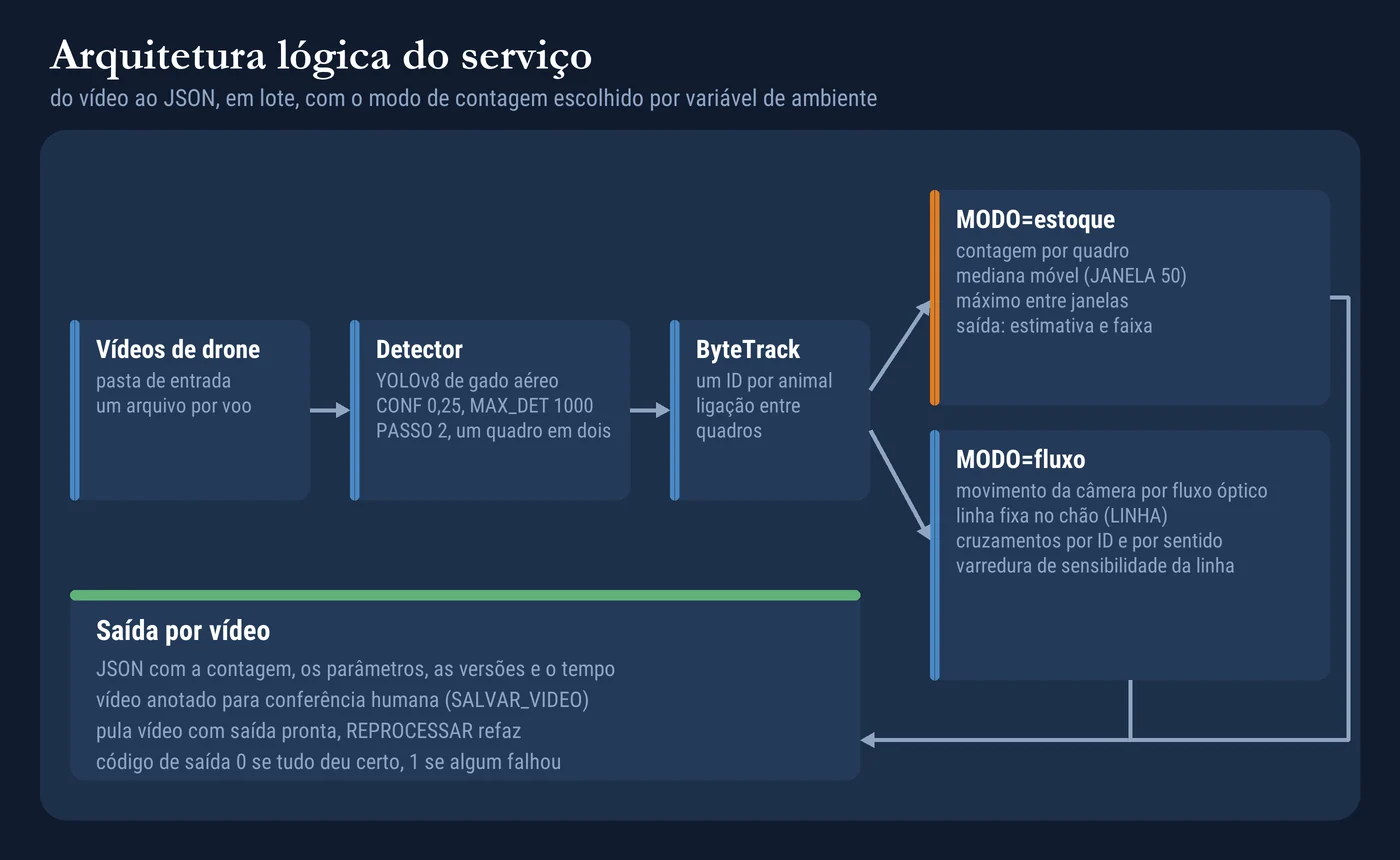
Por dentro, o caminho é curto. O vídeo entra, o detector acha as caixas, o rastreador dá um ID a cada animal e o serviço calcula o número e grava o JSON.
Usei dois vídeos de drone com gado, um de pasto (4K, 35 s, vídeo 2766950) e um de rebanho em movimento (Full HD, 60 fps, 15 s, vídeo 12509069), ambos do Pexels. A ideia é mostrar o que dá para fazer com um modelo pronto e um rastreador, e onde a contagem deixa de ser confiável.
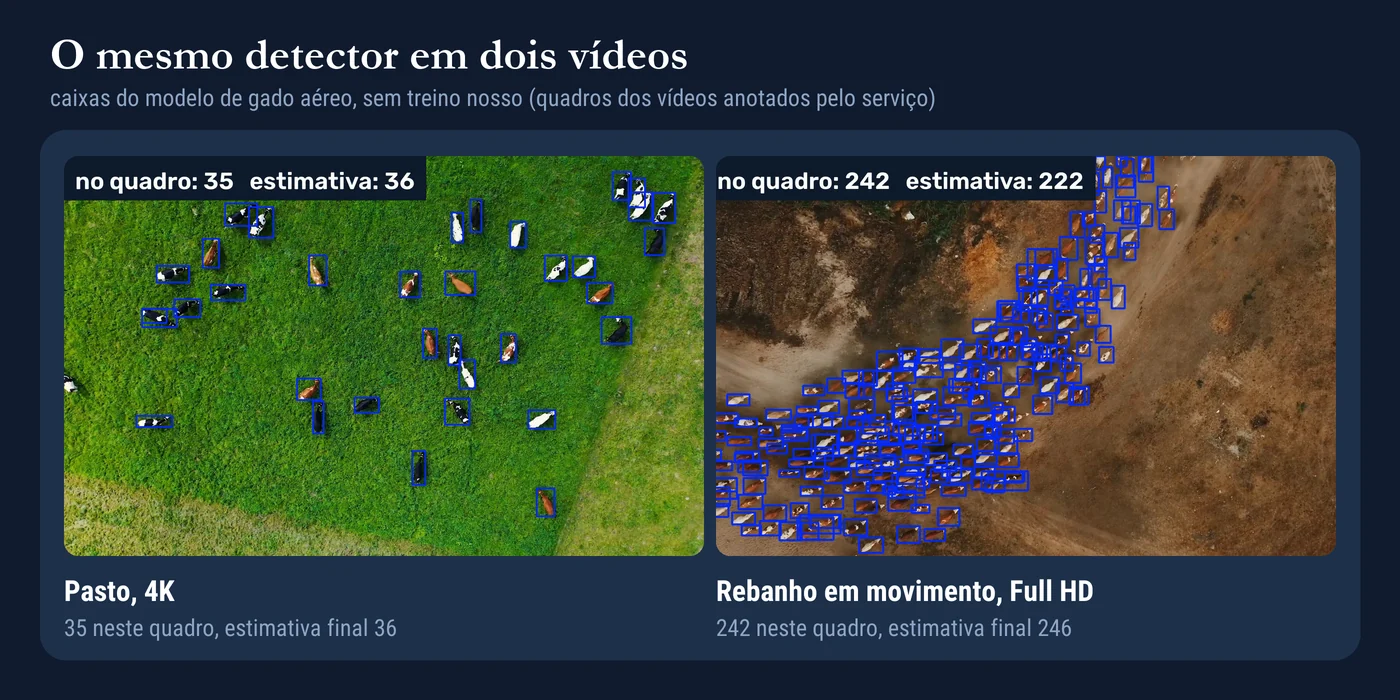
O detector: um modelo de gado visto de cima
A gente costuma achar que um modelo treinado no COCO conta gado em qualquer lugar, mas ele aprendeu a ver vaca de lado, em pé no pasto. Visto de cima por um drone, o animal vira uma mancha comprida, e os modelos genéricos que testei devolveram poucas caixas ou nenhuma. Quer dizer que o modelo não era ruim, só foi treinado para outra imagem. Então fui atrás de um detector já ajustado para gado em imagem aérea e achei o cattle-detection-yolov8, do nsagatov1, um YOLOv8 publicado no Hugging Face (licença AGPL-3.0, que explico mais adiante). Baixei o best.pt e guardei o SHA-256 dele no modelo.json, para saber depois qual arquivo gerou cada número.
As métricas que vêm com o modelo são do autor, medidas em dados que não são os meus, então só afirmo o que vi nos dois vídeos. Na prática, olho a mediana da contagem por quadro, que é o valor do meio quando a gente ordena a contagem de todos os quadros. No pasto ela dá 35 vacas, e a contagem de referência também deu 35 nos seis quadros que conferi. No rebanho a mediana é de 209, e a conta já não fecha tão bem, como mostro na seção de validação.
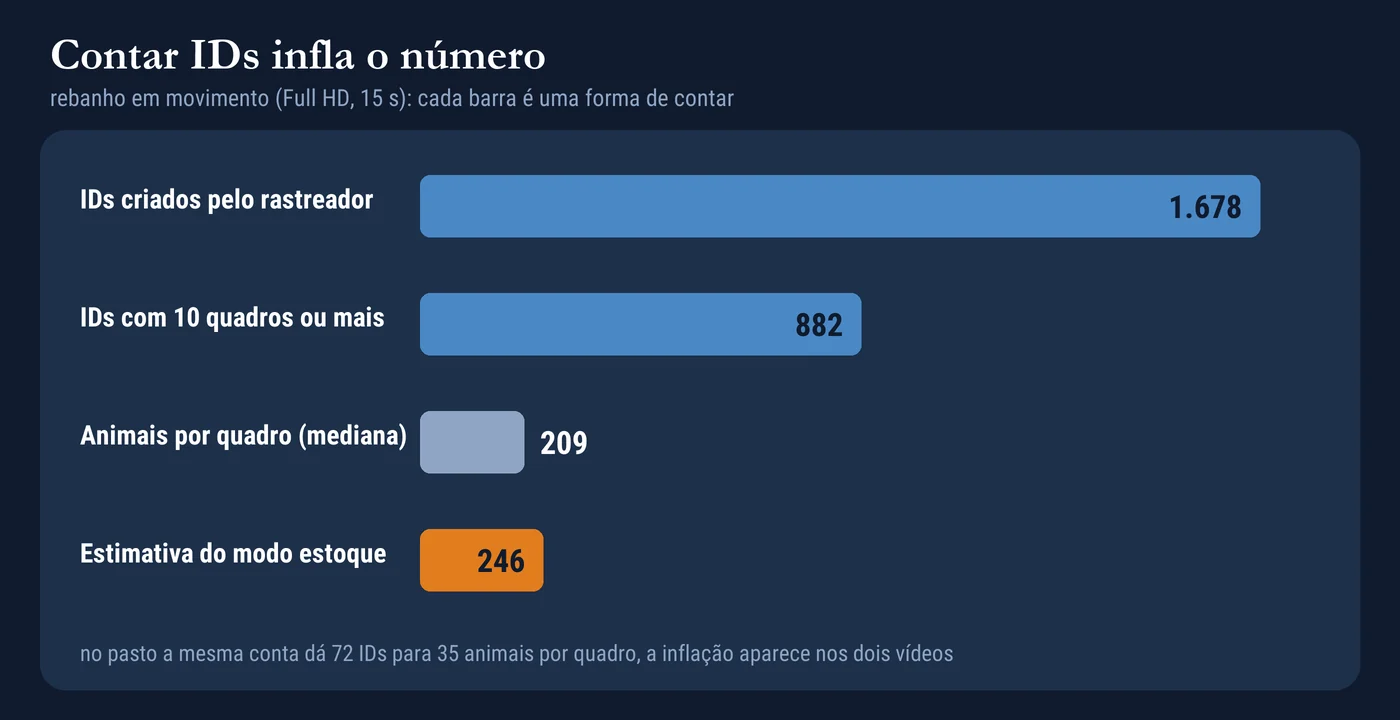
Por que contar IDs únicos não funciona
O caminho óbvio é rastrear (tracking) cada animal, dar um ID e contar IDs. Usei o ByteTrack, que no meu teste foi quatro vezes mais rápido que o BoT-SORT em 4K com contagens parecidas (os dois são rastreadores, que ligam as caixas de quadros seguidos para dar um ID a cada animal).
O problema é que o rastreador perde e reencontra o mesmo animal, e cada reencontro pode virar um ID novo.
| Vídeo | IDs criados | IDs com 10+ quadros | Animais por quadro (mediana) |
|---|---|---|---|
| Pasto (4K) | 72 | 46 | 35 |
| Rebanho (Full HD) | 1.678 | 882 | 209 |
No rebanho, a contagem por IDs daria cerca de oito vezes a mediana por quadro (1.678 contra 209). Mesmo só com os IDs que duram 10 quadros ou mais, que descarta os efêmeros, são 882, cerca de quatro vezes. Isso muda a pergunta de arquitetura. Se o número final não sai do rastreador, ele sai da contagem por quadro (o número de caixas detectadas em cada quadro), e o rastreador deixa de ser o centro do serviço.
Dois modos de contagem, porque são dois problemas
Para um rebanho parado ou quase parado, o que eu quero é um estoque, quantos animais existem. Para gado que anda, o que eu quero é um fluxo, quantos passaram por um ponto. O serviço tem os dois, escolhidos por MODO.
No modo estoque, a ideia é achar o momento em que o rebanho inteiro está à vista, porque ele entra e sai de cena durante o vídeo. Deslizo uma janela de 50 quadros processados pelo vídeo. Como o PASSO é 2, o serviço processa um quadro a cada dois, e a janela cobre 100 quadros do vídeo. Em cada posição tiro a mediana da contagem de animais, e a estimativa é a maior dessas medianas.
A mediana evita que um quadro isolado, com uma caixa duplicada ou um animal cortado na borda, decida o número. Por isso a estimativa de 246 do rebanho é maior que a mediana de 209 do vídeo inteiro, já que 209 inclui os momentos em que o rebanho ainda não chegou ou já saiu.
def mediana_movel_maxima(serie, janela):
    """Maior mediana de `janela` quadros seguidos (ou a mediana da série toda, se ela for mais curta)."""
    if len(serie) <= janela:
        return statistics.median(serie) if serie else 0
    return max(statistics.median(serie[a:a + janela]) for a in range(len(serie) - janela + 1))
O JSON guarda também o máximo de um quadro isolado. A faixa vai da estimativa até esse máximo, que funciona como limite superior. Ela não é um intervalo de confiança, é só a distância entre a estimativa e o pico de um quadro. E como a estimativa é o máximo de várias medianas, ela tende a ficar acima do valor típico por construção.
pasto     estimativa 36   faixa [36, 39]   (manual: 35)
rebanho   estimativa 246  faixa [246, 265]
No pasto o número bate com a contagem de referência. No rebanho a referência é maior (veja a seção de validação), então a faixa, entre 246 e 265, deve ser lida com essa ressalva.
Para ver o quanto a escolha do estimador pesa, comparei quatro deles na contagem por quadro, que o JSON agora guarda.
| Estimador | Pasto | Rebanho |
|---|---|---|
| Mediana do vídeo todo | 35 | 209 |
| Percentil 90 da contagem por quadro | 36 | 241 |
| Maior mediana de janela (a estimativa do serviço) | 36 | 246 |
| Maior quadro isolado | 39 | 265 |
No pasto os quatro ficam entre 35 e 39. No rebanho, a mediana do vídeo todo (209) fica bem abaixo, e o percentil 90 (241) é só 2% menor que a estimativa (246). O viés para cima do máximo das medianas existe por construção, mas é pequeno nestes vídeos.
O modo fluxo e a câmera que se mexe
Contar o que cruza uma linha parece simples, até a câmera se mexer. Num drone que acompanha o gado, uma linha desenhada na imagem anda junto com a câmera e não marca nenhum ponto do chão. Por isso o modo fluxo estima quanto a câmera se moveu entre um quadro e outro, medindo como o fundo da imagem se desloca, e corrige a posição de cada animal, como se a câmera estivesse parada. A linha passa a ficar fixa no chão.
Um ID cruza a linha quando passa de um lado para o outro entre dois quadros, e conta uma vez por sentido. Como só importa esse cruzamento, perder e reencontrar um animal pesa menos do que na contagem de IDs.
A linha também precisa de orientação. Uma linha vertical na imagem não atravessa um rebanho que anda na diagonal, e a contagem passa a depender de um ângulo que ninguém escolheu.
Com LINHA=auto, o serviço mede para onde os animais andam nos primeiros 60 quadros processados e põe a linha atravessada nessa direção, no centro do rebanho. O sentido positivo é o do movimento, e depois disso a linha não muda. Quando você sabe por onde o gado passa, LINHA também aceita dois pontos.
No vídeo do rebanho, a câmera acompanha e sobe. Para saber se o número do fluxo é firme, o JSON repete a contagem com a linha deslocada ao longo do movimento, e a tabela mostra o resultado. Na posição calculada (deslocamento 0), 90 animais cruzaram no sentido do movimento e 10 no contrário.
| Deslocamento da linha (px) | Sentido positivo | Sentido negativo |
|---|---|---|
| -200 | 117 | 21 |
| -100 | 102 | 10 |
| 0 | 90 | 10 |
| +100 | 85 | 3 |
| +200 | 78 | 6 |
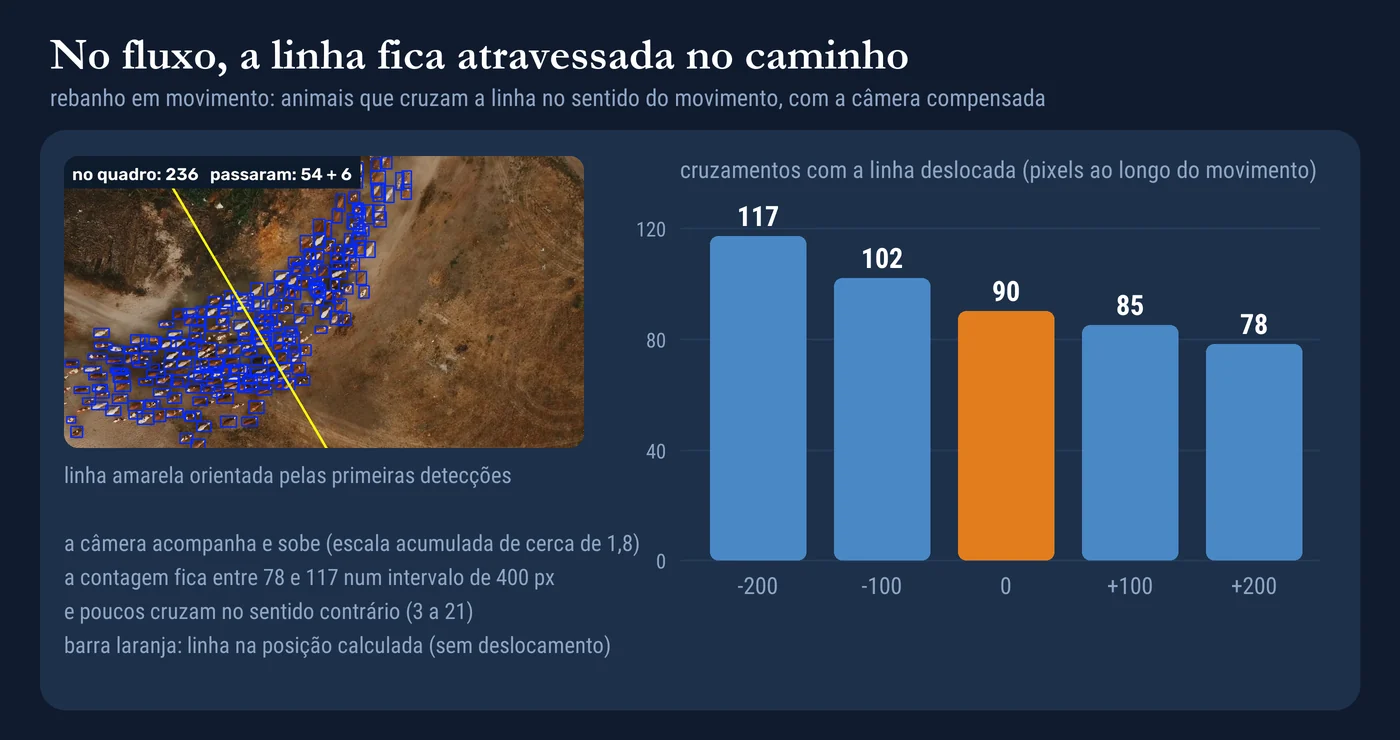
Deslocando a linha, a contagem varia de 78 a 117, e a variação mostra o quanto o número depende de onde a linha cai.
Os poucos animais que cruzam no sentido contrário parecem ruído, IDs que oscilam sobre a linha.
Há ainda uma limitação do próprio vídeo, porque em 15 s o rebanho não atravessa a linha por inteiro. O fluxo diz quantos passaram durante o vídeo (90 na linha calculada, e de 78 a 117 conforme a posição da linha). O estoque diz quantos estavam à vista (246). São perguntas diferentes. O JSON do fluxo traz a varredura junto do número principal, porque um resultado sem ela pareceria mais firme do que é.
No vídeo do pasto, onde o gado pasta quase sem andar, o mesmo modo conta de 2 a 4 animais cruzando a linha, conforme a posição. É o esperado, porque ninguém atravessa nada, e mostra que o fluxo não é uma versão pior do estoque. É outra medida.
Na prática, a escolha depende do que o drone fez. Para voo parado ou lento sobre um rebanho que está num lugar, estoque. Para uma passagem em que o gado realmente cruza um ponto (corredor, porteira, curral), fluxo. Se nenhum dos dois serve, o serviço não escolhe por você. Ele usa o MODO configurado e registra no JSON o modo que foi usado.
Quanto o número se aproxima da contagem de referência
Para saber se o número se aproxima da realidade, montei uma contagem de referência em 9 quadros dos vídeos originais, 6 do pasto e 3 do rebanho, nos mesmos instantes em que o serviço tem a contagem por quadro. As imagens são os quadros brutos, sem as caixas do detector. Cada quadro foi contado de forma independente, às cegas em relação ao resultado do detector, três vezes no pasto e duas no rebanho. As contagens foram feitas com apoio de IA e eu validei o resultado. No rebanho, que é denso, dividi cada quadro em nove blocos e contei bloco a bloco.
No pasto, as três contagens coincidem em 35 animais nos seis quadros. O detector contou 35, 35, 35, 33, 34 e 35, um erro de no máximo dois animais, sempre para menos.
| Quadro do rebanho | Contagem A | Contagem B | Referência (média) | Detector | Detector contra a referência |
|---|---|---|---|---|---|
| 1 | 211 | 238 | 224,5 | 193 | -14% |
| 2 | 277 | 280 | 278,5 | 242 | -13% |
| 3 | 277 | 260 | 268,5 | 209 | -22% |
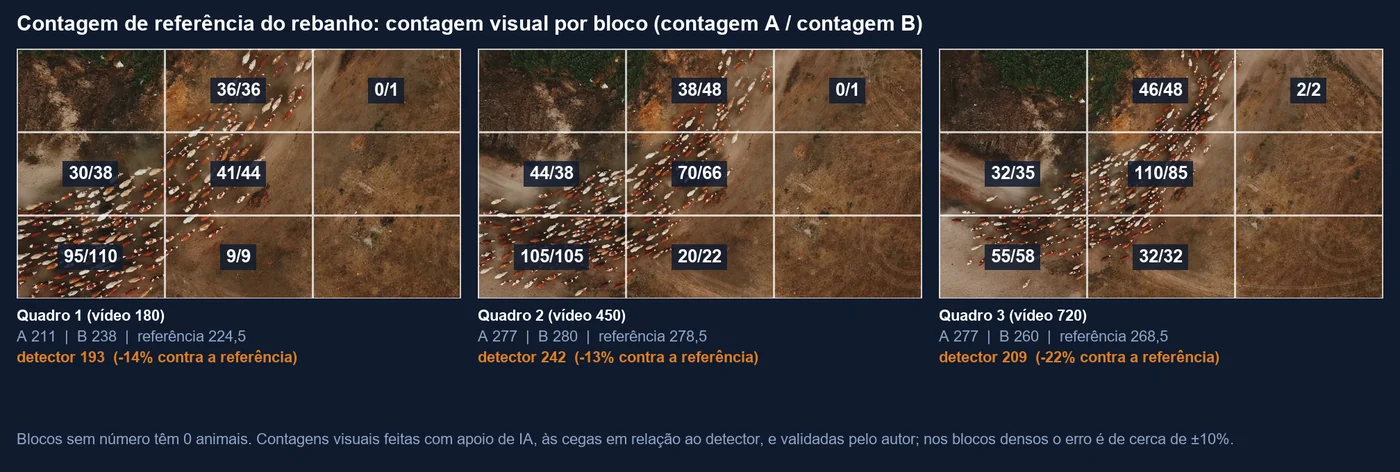
No rebanho, o detector conta de 13% a 22% menos que a referência. A referência tem erro próprio, porque nos blocos mais densos os animais se sobrepõem (as duas contagens divergem de 1% a 12%, e o erro nesses blocos é de cerca de 10%), mas a diferença é maior que essa incerteza nos três quadros. Por isso a estimativa de 246 deve ser lida como provavelmente baixa para este rebanho. No quadro mais cheio, a referência fica entre 277 e 280, contra os 242 que o detector contou.
São nove quadros de dois vídeos, então isso mostra o sentido do erro e não permite estimar um fator de correção. Em rebanho denso, vale calibrar o serviço com uma amostra sua.
A imagem Docker: modelo fixo, código mínimo
Aqui está a decisão de arquitetura que mais pesa. O modelo entra na imagem em tempo de build. Cada imagem carrega exatamente uma versão do modelo, e o serviço roda sem rede, com as verificações online do Ultralytics desligadas (YOLO_OFFLINE=1) e a telemetria dele desativada na inicialização.
# a base é fixada pelo digest, então uma reconstrução futura parte da mesma imagem
FROM pytorch/pytorch:2.6.0-cuda12.4-cudnn9-runtime@sha256:77f17f843507062875ce8be2a6f76aa6aa3df7f9ef1e31d9d7432f4b0f563dee

# o serviço não usa rede: sem verificações online do Ultralytics e com a pasta de configuração onde o usuário pode escrever
ENV PYTHONUNBUFFERED=1 \
    PIP_NO_CACHE_DIR=1 \
    YOLO_OFFLINE=1 \
    YOLO_CONFIG_DIR=/tmp

# bibliotecas de sistema que o OpenCV (dependência do Ultralytics) precisa
RUN apt-get update \
    && apt-get install -y --no-install-recommends libgl1 libglib2.0-0 \
    && rm -rf /var/lib/apt/lists/*

WORKDIR /app
COPY requirements-servico.txt .
# lock com hashes: o pip só instala o que bate com o hash e não resolve mais nada sozinho
RUN pip install --require-hashes --no-deps -r requirements-servico.txt

# o modelo escolhido entra na imagem, então o serviço roda sem rede e cada imagem carrega uma versão fixa
COPY modelos/atual/modelo.pt /app/modelo.pt
COPY modelos/atual/modelo.json /app/modelo.json
COPY servico.py ./

RUN useradd --create-home app && chown -R app /app
USER app

ENTRYPOINT ["python", "servico.py"]
O modelo.json ao lado do .pt registra a origem, a licença, o SHA-256 do arquivo e as métricas declaradas pelo autor, com a observação de que o modelo foi usado como veio.
O código roda como usuário comum. A base está fixada por digest, e as 22 dependências que o pip instala por cima dela (entre elas ultralytics, lap e o OpenCV) estão travadas com hash, então uma reconstrução parte do mesmo ponto. O que ficou sem fixar são os pacotes de sistema que o apt instala (libgl1 e libglib2.0-0).
O restante da configuração vem de variáveis de ambiente, e o docker-compose.yml reserva a GPU e monta uma pasta de dados.
services:
  contador:
    build: .
    image: contador-gado:1.0
    init: true
    shm_size: "2gb"
    environment:
      ENTRADA: /dados/entrada
      SAIDA: /dados/saida
      MODO: estoque
      CONF: "0.25"
      IMGSZ: "1920"
      MAX_DET: "1000"
      RASTREADOR: bytetrack.yaml
      PASSO: "2"
      JANELA: "50"
      SALVAR_VIDEO: "1"
    volumes:
      - ./dados:/dados
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
    restart: "no"
Alguns detalhes parecem bobagem, mas pesam em operação. O restart: "no" existe porque é um serviço de lote, que termina quando acabam os vídeos. O MAX_DET=1000 existe porque o Ultralytics limita a 300 detecções por quadro por padrão, e um rebanho denso bate nesse teto sem avisar. O PASSO=2 processa um quadro a cada dois para reduzir o tempo, e a seção de escala mostra o efeito na contagem.
Contrato de saída: um JSON por vídeo
Para cada vídeo, o serviço escreve <video>_<modo>.json e, se SALVAR_VIDEO=1, um vídeo anotado (o vídeo original com as caixas e o contador desenhados) para conferência humana. O JSON traz o resultado, a contagem de cada quadro, os parâmetros usados, as versões das bibliotecas (inclusive NumPy e OpenCV), o SHA-256 do modelo, o dispositivo e o tempo gasto. O SHA-256 é calculado na subida e conferido com o modelo.json. Troquei um caractere desse hash para testar, e o serviço recusou o modelo e saiu com código 1. Se o arquivo de saída já existe, o vídeo é pulado (REPROCESSAR=1 força refazer), então rodar o lote duas vezes não duplica trabalho. O código de saída é 0 quando todos os vídeos deram certo e 1 quando algum falhou, e é isso que um agendador ou um pipeline de CI lê.
Só números e metadados saem do contêiner. O vídeo bruto fica na pasta de entrada.
Rodando no Docker
O build gera a imagem contador-gado:1.0. Depois são duas execuções, uma por modo, sobre a mesma pasta com os dois vídeos.
docker compose build
docker compose run --rm contador
docker compose run --rm -e MODO=fluxo contador
O serviço escreve um evento JSON por linha. Estes são os do modo estoque, com "dispositivo": "0" confirmando que o contêiner enxergou a GPU.
{"evento": "inicio", "videos": 2, "modo": "estoque", "dispositivo": "0", "ultralytics": "8.4.142"}
{"evento": "concluido", "video": "12509069_1920_1080_60fps.mp4", "segundos": 67.8, "modo": "estoque", "ids_criados": 1678, "ids_com_duracao_minima": 882, "maximo_num_quadro": 265, "mediana_por_quadro": 209.0, "estimativa_animais": 246.0, "faixa": [246.0, 265]}
{"evento": "concluido", "video": "2766950-uhd_3840_2160_30fps.mp4", "segundos": 133.0, "modo": "estoque", "ids_criados": 72, "ids_com_duracao_minima": 46, "maximo_num_quadro": 39, "mediana_por_quadro": 35, "estimativa_animais": 36.0, "faixa": [36.0, 39]}
{"evento": "fim", "falhas": 0}
As quatro execuções saíram com código 0. Os tempos incluem carregar o modelo, detectar e rastrear, e cada um vem de uma única execução, sem repetição. A coluna sem vídeo anotado vem de uma repetição do estoque com SALVAR_VIDEO=0, e as contagens saíram idênticas (246 e 36).
Rodei também o fluxo do rebanho, com vídeo anotado, com docker run --network none (sem rede nenhuma). O resultado foi o mesmo, 90 e 10.
| Vídeo | Estoque, sem vídeo anotado | Estoque, com vídeo anotado | Fluxo, com vídeo anotado |
|---|---|---|---|
| Rebanho, Full HD, 15 s | 39 s | 68 s | 92 s |
| Pasto, 4K, 35 s | 30 s | 133 s | 155 s |
Licença: o que dá para fazer com isso
Ferramenta pronta quase sempre vem com condição. O modelo que usei é AGPL-3.0, segundo a página dele no Hugging Face, e a biblioteca Ultralytics que carrega o modelo também é AGPL-3.0, com uma licença comercial paga como alternativa, descrita na página de licenças da Ultralytics.
Rodar o serviço dentro de casa, em lote, sobre os seus vídeos, e usar só os números, é o caso mais tranquilo. O problema aparece quando você distribui a imagem Docker ou oferece o contador como serviço pela rede, porque a AGPL pede que quem usa o serviço possa receber o código-fonte dele. Se o contador vai virar produto, as saídas são contratar a licença comercial ou trocar o detector por um com licença permissiva, treinado nos seus próprios dados.
Um cuidado com os vídeos. Os de teste do Pexels servem só para demonstração, porque em operação os vídeos são seus, com a permissão de quem filmou.
Como escalar
Medi o uso da GPU e o tempo das execuções no contêiner. A divisão em réplicas (outras cópias do contêiner), mais adiante, é proposta e não foi testada. Durante as execuções, a GPU ficava entre 7% e 30% e o contêiner usava pouco mais de um núcleo, numa máquina de 20 threads. Nenhum dos dois estava saturado, porque o serviço processa um quadro por vez, em série, e a GPU espera a CPU entre um quadro e outro.
No perfil do rebanho (com o cProfile do Python, dentro do contêiner), a rede neural, a única parte que usa a placa, levou menos de 20% do tempo, e o rastreador ByteTrack, perto de 40%. É por isso que a GPU fica ociosa.
Pela tabela da seção anterior, gravar o vídeo anotado acrescenta 29 s no Full HD, mais de 40% do tempo, e 103 s no 4K, três quartos do tempo. A decisão de operação é simples, SALVAR_VIDEO=0 por padrão e o vídeo anotado só para conferência por amostragem. Vale também medir com a máquina parada, porque as minhas primeiras medições, feitas com outras tarefas rodando, deram tempos cerca de três vezes maiores.
Para ir mais rápido numa máquina, os outros botões são PASSO e IMGSZ (entrada menor, que não medi), e os dois trocam precisão por tempo. Medi o PASSO no estoque, sem vídeo anotado, mantendo a janela em cerca de 100 quadros do vídeo (JANELA 100, 50 e 33).
PASSO |
Pasto, estimativa | Pasto, tempo | Rebanho, estimativa | Rebanho, tempo |
|---|---|---|---|---|
| 1 | 36 | 55 s | 251,5 | 71 s |
| 2 | 36 | 30 s | 246 | 39 s |
| 3 | 36 | 24 s | 241 | 28 s |
Processar todos os quadros custa quase o dobro do tempo de PASSO=2, e a estimativa do rebanho sobe de 246 para 251,5, cerca de 2%. Com PASSO=3 ela desce para 241. O pasto não muda. Nestes dois vídeos o efeito é pequeno, mas cada ponto é uma execução só.
Para ir além de uma máquina, o serviço já ajuda em dois pontos. A imagem tem tudo dentro, inclusive o modelo, e não precisa de rede, então vai para qualquer lugar com GPU. E a saída existente é pulada, então um lote interrompido recomeça de onde parou.
O que falta é dividir o trabalho. Hoje o serviço lista a pasta inteira, então duas réplicas apontadas para a mesma pasta pegariam os mesmos vídeos. Para escalar de verdade, cada réplica precisa receber um subconjunto, por pasta ou por uma fila de vídeos, com os vídeos e os JSONs em armazenamento compartilhado. A partir daí, o que eu vigiaria é o tempo por vídeo no JSON, o código de saída de cada execução e o log em JSON, que já saem prontos.
Quando usar e quando não usar
Este desenho serve para operação em lote com um modelo fixo, onde o que importa é saber qual versão produziu qual número. Ele não substitui uma validação com contagem manual em vídeos do seu rebanho, e eu fiz isso em nove quadros de dois vídeos. Antes de tratar o número como oficial, vale ter uma amostra de vídeos contados à mão, para dizer o erro típico em cada modo.
A parte que dura é o contrato de execução, o modelo preso à imagem, o modo declarado, a faixa em vez de um número solto e o JSON que explica como o número foi obtido. O que esse contrato não garante é que o número esteja certo. Nos nove quadros que conferi, ele acerta no pasto e subconta o rebanho denso, e falta validar em mais vídeos.
O código está no repositório do blog no GitHub. O modelo não vai junto, e o README explica onde baixá-lo.
Referências
JOCHER, Glenn; QIU, Jing; CHAURASIA, Ayush. Ultralytics YOLO. Versão 8.0.0. Ultralytics, 2023. Software, licença AGPL-3.0. github.com/ultralytics/ultralytics
NSAGATOV1. cattle-detection-yolov8. Hugging Face, 2026. Modelo, licença AGPL-3.0. huggingface.co/nsagatov1/cattle-detection-yolov8
ZHANG, Yifu; SUN, Peize; JIANG, Yi; YU, Dongdong; WENG, Fucheng; YUAN, Zehuan; LUO, Ping; LIU, Wenyu; WANG, Xinggang. ByteTrack: multi-object tracking by associating every detection box. In: Computer Vision, ECCV 2022. Lecture Notes in Computer Science. Cham: Springer Nature Switzerland, 2022. p. 1-21. DOI: 10.1007/978-3-031-20047-2_1


