

Atualizado 2026 (publicado em 2021)
Algoritmo genético, busca aleatória, TPE e CMA-ES: qual método acha melhores hiperparâmetros


A gente já aprende que a configuração padrão de um modelo raramente é a melhor, e que vale gastar um tempo ajustando os hiperparâmetros. Mas me veio a dúvida de quanto esse ajuste rende de verdade, e se um método de busca mais esperto ganha de simplesmente sortear configurações. Também queria ver um algoritmo genético escrito por mim na mesma briga com os métodos que o Optuna traz prontos.
Montei o experimento com o mesmo orçamento para todos, 60 avaliações do objetivo, e repeti cada método com 10 sementes diferentes, porque uma execução só pode ter dado sorte. A métrica é a PR-AUC, a área sob a curva de precisão e recall, em que 1 é perfeito. Ajustar o LightGBM subiu a PR-AUC no teste de 0,634 para cerca de 0,66, e os quatro métodos de busca ficaram a no máximo 0,002 um do outro. Mostro o caminho, e também onde esse resultado não vale.
O código está no repositório do blog no GitHub.
A tarefa e o orçamento
A tarefa é prever a evasão de clientes de telecomunicações na base Telco Customer Churn, com 7.043 clientes, usando um LightGBM. Separei 20% dos clientes como teste lacrado (dados que a busca nunca vê), que só avalia a melhor configuração de cada execução, depois que a busca termina. Os 80% restantes (5.634 clientes) servem à busca, e o objetivo que cada método tenta maximizar é a PR-AUC em validação cruzada estratificada de 3 dobras, só dentro desse treino.
São 7 hiperparâmetros, cada um com a faixa que a busca pode explorar. Os que variam em ordem de grandeza (taxa de aprendizado e regularização) usam escala logarítmica.
# nome: (tipo, mínimo, máximo, escala logarítmica)
ESPACO = {
    "n_estimators": ("int", 50, 400, False),
    "learning_rate": ("float", 0.005, 0.3, True),
    "num_leaves": ("int", 4, 96, False),
    "min_child_samples": ("int", 5, 100, False),
    "subsample": ("float", 0.5, 1.0, False),
    "colsample_bytree": ("float", 0.4, 1.0, False),
    "reg_lambda": ("float", 0.001, 10.0, True),
}
Como referência entra a configuração padrão do LightGBM (100 árvores, taxa 0,1, 31 folhas), que teve 0,6438 de PR-AUC na validação cruzada e 0,6338 no teste lacrado.
Os quatro métodos
A busca aleatória sorteia uma configuração dentro das faixas, avalia e guarda a melhor. Não aprende nada com as avaliações anteriores, e por isso é a régua que os outros precisam bater. O TPE (Tree-structured Parzen Estimator) e o CMA-ES vêm do Optuna, e os dois usam o histórico para decidir onde sortear a próxima configuração. O TPE sorteia mais perto das configurações que foram bem, e o CMA-ES ajusta a distribuição dos sorteios na direção das melhores. Os dois começam com 10 avaliações aleatórias, que contam nas 60, antes de passar a usar o histórico.
O quarto é o algoritmo genético, que eu escrevi. A ideia é simples. Cada hiperparâmetro é um gene, e um indivíduo é uma configuração inteira, com os 7 genes. Começamos com 10 indivíduos sorteados e medimos a PR-AUC de cada um, que é a aptidão (fitness). Para formar um filho, sorteamos 3 indivíduos e o de maior aptidão vira pai, e repetimos o torneio para ter dois pais. No cruzamento (crossover), cada gene do filho é sorteado entre os valores dos pais, com uma folga de 30% da distância entre eles para cada lado, para o filho poder ir um pouco além dos pais. Depois vem a mutação, em que cada gene tem 20% de chance de receber um ruído gaussiano. No fim, juntamos pais e filhos, e só os 10 de maior aptidão passam para a geração seguinte.
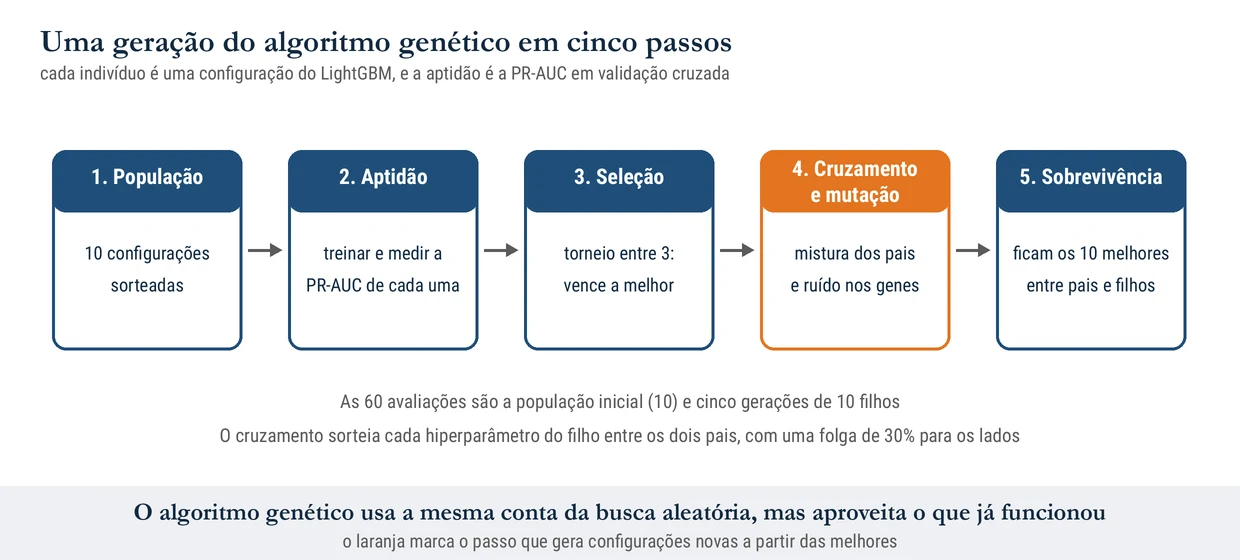
Cada indivíduo é um vetor de 7 números entre 0 e 1, que uma função converte nos hiperparâmetros reais (com a escala logarítmica quando for o caso). Isso deixa o cruzamento e a mutação independentes das unidades de cada parâmetro.
def genetico(obj, n, semente, populacao=10, torneio=3, p_cruz=0.8, alfa=0.3, p_mut=0.2, sigma=0.12):
    rng = np.random.default_rng(semente)
    d = len(NOMES)
    hist = []

    def avaliar(u):
        p = de_unitario(u)
        s = obj(p)
        hist.append((p, s))
        return s

    pop = [rng.random(d) for _ in range(populacao)]
    fit = [avaliar(u) for u in pop]
    while len(hist) < n:
        filhos = []
        while len(filhos) < populacao and len(hist) + len(filhos) < n:
            def escolher():
                idx = rng.choice(len(pop), torneio, replace=False)
                return pop[max(idx, key=lambda i: fit[i])]
            a, b = escolher(), escolher()
            if rng.random() < p_cruz:
                lo, hi = np.minimum(a, b), np.maximum(a, b)
                amp = hi - lo
                filho = rng.uniform(lo - alfa * amp, hi + alfa * amp)
            else:
                filho = a.copy()
            mut = rng.random(d) < p_mut
            filho = np.clip(filho + mut * rng.normal(0, sigma, d), 0, 1)
            filhos.append(filho)
        fit_f = [avaliar(u) for u in filhos]
        todos, fits = pop + filhos, fit + fit_f
        ordem = np.argsort(fits)[::-1][:populacao]
        pop, fit = [todos[i] for i in ordem], [fits[i] for i in ordem]
    return hist
Com 60 avaliações, o genético usa a população inicial (10) e cinco gerações de 10 filhos, ou seja, 10 + 5 × 10 = 60.
Todos chegam rápido ao mesmo lugar
A figura 2 mostra o melhor valor de validação encontrado até a avaliação n, na média das 10 execuções de cada método. As 10 execuções de cada método passaram de 0,66 de PR-AUC de validação, bem acima da configuração padrão, e a mediana de avaliações até passar de 0,66 foi 2 nos quatro métodos.
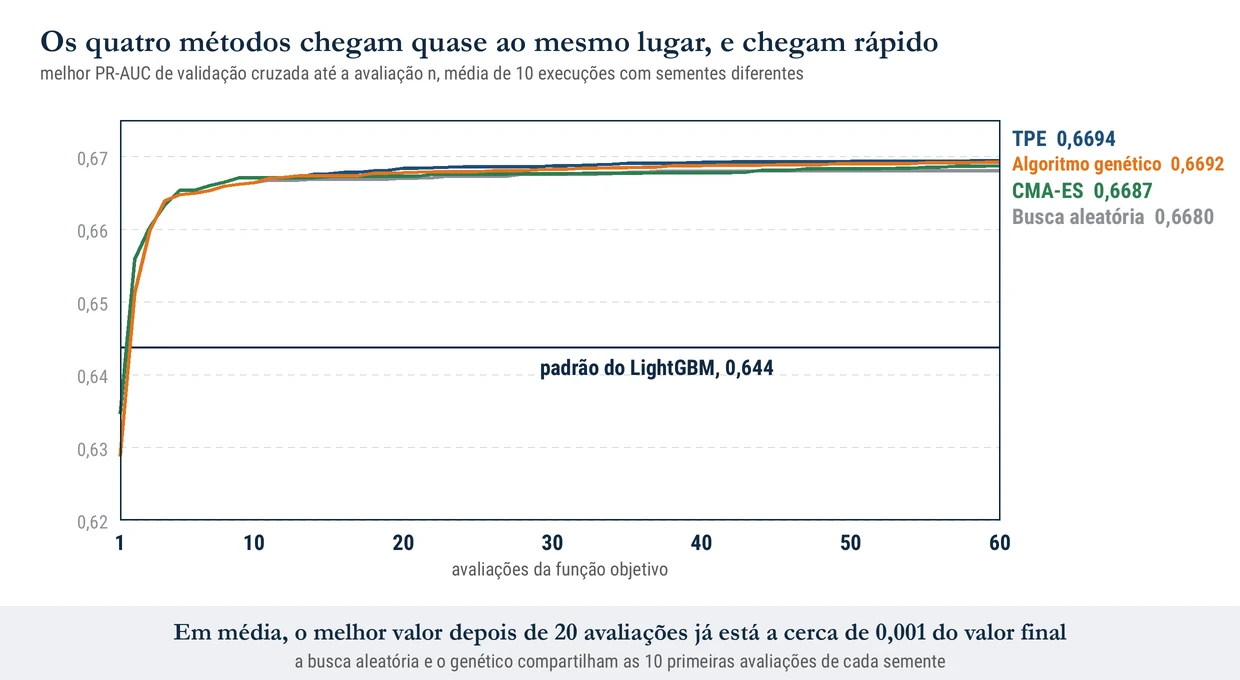
Como um ou dois sorteios já passam do padrão, o espaço de busca é generoso, e quase qualquer configuração razoável supera o padrão. As 40 avaliações seguintes refinam pouco.
| Método | PR-AUC de validação, média (desvio) | PR-AUC de teste, média (desvio) | Teste, mínimo e máximo |
|---|---|---|---|
| TPE (Optuna) | 0,6694 (0,0006) | 0,6629 (0,0024) | 0,6599 a 0,6674 |
| Algoritmo genético | 0,6692 (0,0008) | 0,6618 (0,0019) | 0,6585 a 0,6640 |
| CMA-ES (Optuna) | 0,6687 (0,0010) | 0,6615 (0,0029) | 0,6565 a 0,6662 |
| Busca aleatória | 0,6680 (0,0006) | 0,6605 (0,0025) | 0,6562 a 0,6650 |
| Padrão do LightGBM | 0,6438 | 0,6338 |
A ordem é a mesma na validação e no teste, com o TPE na frente e a busca aleatória atrás. Mas a distância entre os métodos é do tamanho do desvio entre sementes de um mesmo método, e os dois aparecem na tabela.
No teste lacrado
A figura 3 mostra o teste de cada execução. Os pontos dos quatro métodos se sobrepõem, e todos estão acima da linha preta do padrão.
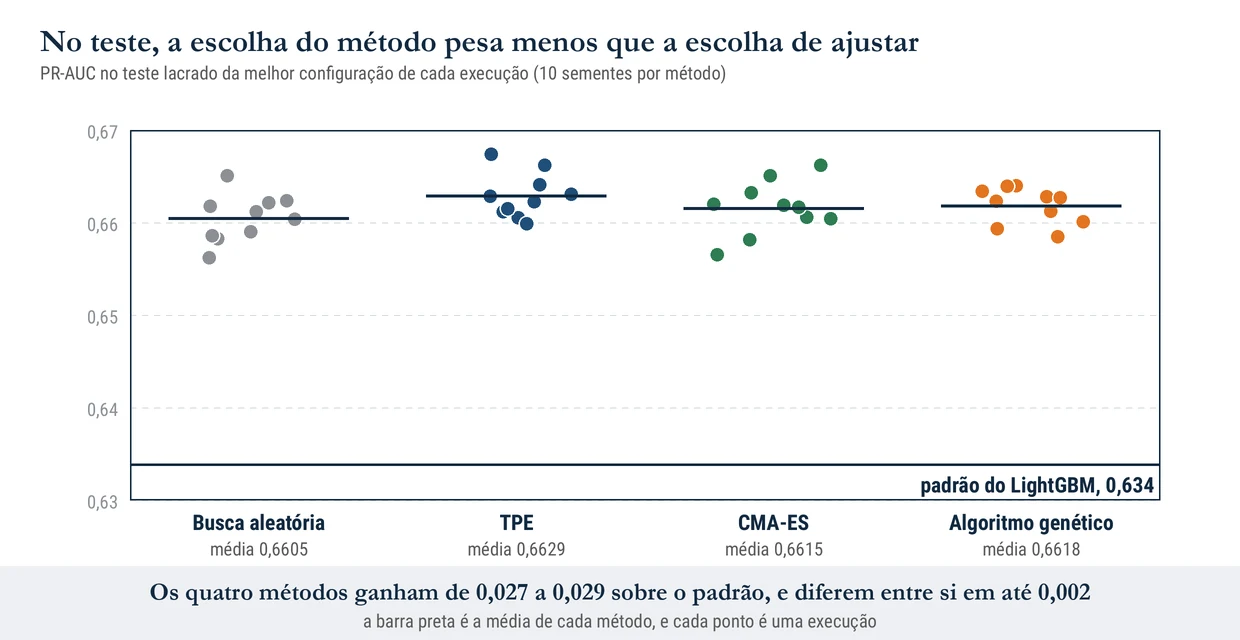
Para saber se a diferença para a busca aleatória é real, comparo cada método com ela, semente por semente. Depois calculo um intervalo de confiança de 95% para a diferença média, sorteando as sementes com reposição muitas vezes (bootstrap). Se o intervalo cruza o zero, a diferença pode ser acaso.
| Método contra a busca aleatória | Validação, diferença (IC 95%) | Teste, diferença (IC 95%) |
|---|---|---|
| TPE | +0,0013 (0,0008 a 0,0019) | +0,0024 (0,0002 a 0,0046) |
| Algoritmo genético | +0,0011 (0,0006 a 0,0017) | +0,0013 (-0,0006 a 0,0034) |
| CMA-ES | +0,0006 (-0,0002 a 0,0014) | +0,0011 (-0,0013 a 0,0033) |
Na validação, o TPE e o genético passam da busca aleatória com o intervalo inteiro acima de zero, mas a validação é o que os métodos tentam maximizar, então ela já está um pouco inflada a favor deles.
O teste, que a busca nunca viu, é o que decide, e nele só o TPE se separa da busca aleatória, e por pouco, porque o limite inferior do intervalo é 0,0002. O genético e o CMA-ES têm diferença positiva, mas o intervalo inclui zero.
E qual método usar? Para este problema, o que dá para afirmar é que ajustar vale a pena e que o método quase não importa. O TPE é uma boa escolha padrão, porque tem a maior média nas duas medidas (validação e teste) e já vem pronto no Optuna. A busca aleatória com 60 avaliações já captura mais de 90% do ganho possível (0,0267 de 0,0291 no teste). O genético só compensa se você precisa de algo que as bibliotecas não oferecem, como restrições entre hiperparâmetros ou um tipo de gene que não seja número.
Onde esse resultado não vale
É uma base, um modelo e um espaço de 7 hiperparâmetros, e o resultado não vale para outros problemas. Num espaço maior ou mais acidentado, como o de uma rede neural, os métodos que usam o histórico podem se separar mais. Os hiperparâmetros do genético (população de 10, torneio de 3, mutação de 0,2) são os que escolhi de antemão, sem ajuste, e outros valores poderiam mudar a ordem. Na comparação, a busca aleatória e o genético partem do mesmo sorteio inicial.
Não comparei tempo de relógio, só o número de avaliações do objetivo, e com treino rápido como este o custo da busca em si é pequeno. A PR-AUC de validação fica cerca de 0,007 acima da de teste nos quatro métodos, e parte disso é a busca se ajustando ao objetivo. Por fim, dez sementes dão intervalos largos, e as diferenças de 0,001 que aparecem aqui são pequenas demais para decidir qualquer coisa em produção.
Para a próxima busca
Se eu fosse ajustar outro modelo amanhã, começaria pela configuração padrão, só para ter a métrica de referência e saber quanto o ajuste rende. Em seguida rodaria de 20 a 30 avaliações de busca aleatória, que neste problema já pegam quase todo o ganho. O TPE entra se cada avaliação custar horas, e o genético fica para quando o que se procura não é um vetor de números, como a ordem em que as caixas entram num baú, que é o assunto do artigo sobre otimização de cargas com algoritmo genético.
E antes de comparar dois métodos, várias sementes. Uma execução bonita pode ser só sorte.
Referências
BERGSTRA, James; BENGIO, Yoshua. Random search for hyper-parameter optimization. Journal of Machine Learning Research, v. 13, p. 281-305, 2012.
AKIBA, Takuya; SANO, Shotaro; YANASE, Toshihiko; OHTA, Takeru; KOYAMA, Masanori. Optuna: a next-generation hyperparameter optimization framework. In: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 25., 2019. DOI: 10.1145/3292500.3330701


